Modelo
SFC-Locoformer: Compresión espectral adaptativa y límites de diálogo para 11,8 dB DnR
Lectura intensiva del artículo / Separación sonora de cine y televisión
Lectura intensiva del artículo / Separación sonora de cine y televisión
© 2026 TelkNet. Todos los derechos reservados.
LECTURA DE PAPER / SEPARACIÓN CINEMATOGRÁFICA
DnR separa una mezcla de programa en diálogo, música y efectos. Esas fuentes se solapan tanto en tiempo como en frecuencia, así que el problema no puede reducirse a una detección de actividad vocal. SFC-Locoformer, BandIt y TIGER-DnR abordan la misma tarea con distintos esquemas de compresión, costes de secuencia y evidencia publicada.
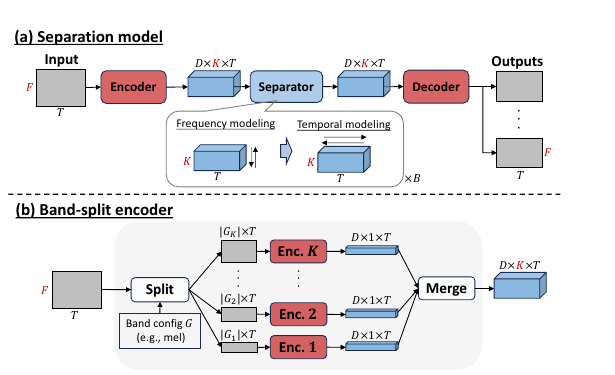
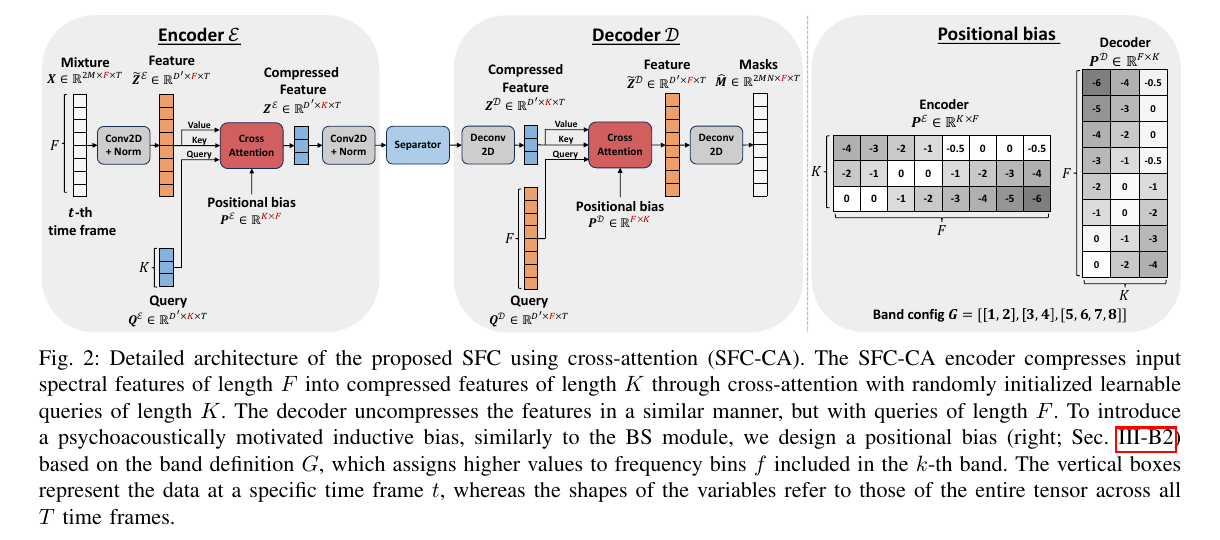
Una STFT produce el espectro complejo X(t,f). Dar a cada bin adyacente el mismo presupuesto de canales gasta cómputo en características altamente correlacionadas. SFC aprende una proyección hacia un eje espectral compacto:
Z(t,k)=Σ_f C(k,f)·[Re X(t,f), Im X(t,f)]
El decodificador usa atención cruzada para devolver la representación comprimida a los bins de frecuencia objetivo. No se trata de un corte de agudos: los transitorios de las consonantes, los armónicos sostenidos y los efectos de banda ancha siguen disponibles para el separador.
Los bloques locales modelan impactos, plosivas y ataques de batería; la comunicación entre ventanas transporta bases musicales, frases completas y ambiente. Un único campo de atención densa haría crecer la memoria bruscamente con la duración. Locoformer combina la mezcla local con un intercambio de largo alcance económico, de modo que el checkpoint medium publicado sigue siendo práctico.
La Tabla II reporta 11.8 dB para SFC-Locoformer medium y 10.9 dB para BandIt bajo el mismo protocolo de prueba DnR. El objetivo invariante de escala es:
SI-SDR=10 log10(||s_target||² / ||e_noise||²)
Sirve para ordenar modelos dentro del protocolo, no para comparaciones contra MUSDB, otra revisión de DnR o clips escogidos a mano. La ventaja de 0.9 dB tampoco garantiza que cada fragmento de película salga ganando; las fricativas, la amplitud del ambiente y los transitorios de efectos aún exigen escucha a ciegas.
Los autores publican los codificadores SFC-CA, SFC-Mamba y BandIt, el separador TF-Locoformer y pesos preentrenados de MUSDB18-HQ y DnR. La arquitectura del paper, la implementación del repositorio y los archivos de la model card pueden así contrastarse entre sí; los 11.8 dB siguen perteneciendo únicamente al protocolo DnR v2 de la Tabla II.
La separación de diálogo, música y efectos ganó una definición de objetivo relativamente estable tras el DnR Challenge de 2021. BandIt centró después la capacidad de modelado en bandas de frecuencia no uniformes, mientras TIGER exploró un modelo de secuencia más barato. SFC-Locoformer plantea otra pregunta de ingeniería: si los bins de frecuencia vecinos son redundantes, ¿pueden comprimirse antes de gastar el presupuesto del modelo en estructuras de diálogo y partitura más largas?
Por esa historia, los tres modelos publicados pertenecen a una misma página de tarea sin describirse como un simple reemplazo de lo viejo por lo nuevo. BandIt es una línea base de división en bandas muy sólida, TIGER ofrece una alternativa orientada al cómputo, y el checkpoint medium de SFC publicado reporta 11.8 dB bajo el mismo protocolo DnR v2 de la Tabla II. La arquitectura, los pesos y el protocolo de evaluación importan por igual.
Z(t,k)=Σ_f A(k,f|X)·W_f·X(t,f)X(t,f)espectro complejo de entradaA(k,f|X)agregación de bandas adaptativa a la entradaZ(t,k)representación comprimida de la secuenciaA no es una regla fija de poda de frecuencias. Es un peso de agregación dependiente de la entrada, de modo que el eje k más corto deja más capacidad de secuencia para el diálogo, la partitura y el ambiente a lo largo del tiempo.
El decodificador sigue consultando con características no comprimidas para restaurar cada bin de salida. La ecuación es una abstracción del flujo de información; CrossAttnEncoder, CrossAttnDecoder y la consulta adaptativa del repositorio son la implementación auditable.
El paper, el código y los pesos pueden seguirse a través del código fuente de SFC-Locoformer / checkpoint DnR publicado / paper de SFC y tabla DnR.
Aquí solo se ordenan filas verificadas bajo el mismo protocolo publicado; TIGER-DnR no se inserta en la Tabla II sin un resultado equivalente.
| Modelo | Resultado publicado | Cómo leerlo |
|---|---|---|
| SFC-Locoformer medium | 11.8 dB SI-SDR | valor publicado más alto de este protocolo; conviene auditar los bordes del diálogo |
| BandIt | 10.9 dB SI-SDR | línea base de división en bandas bajo el mismo protocolo |
| TIGER-DnR | evidencia de eficiencia mostrada aparte | no se mezcla en una fila ausente de la tabla |
En el diálogo, escuche las sibilantes, las respiraciones y el habla lejana. SI-SDR elimina la ganancia global de la comparación, pero puede pasar por alto bordes metálicos y colas de sala dañadas. En la música, busque fantasmas de voz; en los efectos, preserve la continuidad de puertas, pasos y ambiente.
Las mezclas de broadcast también contienen limitación, ducking de diálogo y fold-downs de canales. Un protocolo de paper DnR no representa automáticamente cada máster de entrega; las comparaciones entre SFC, BandIt y TIGER deben usar los mismos fragmentos y auditar por separado los bordes del diálogo, las fugas de música y la continuidad del ambiente.
El stem de efectos es un contenedor amplio. Lluvia, tráfico, aplausos y foley siguen combinados, así que la salida DnR no es una descomposición sonora a nivel de objeto.
Las condiciones de licencia aguas arriba siguen rigiendo el despliegue y la redistribución, aunque la forma de la tarea ya no interrumpa el flujo de trabajo con una lección sobre licencias de modelos.
Los nombres de modelos, las cifras y las limitaciones se remontan a los papers, repositorios o model cards siguientes.