SFC-Locoformer: Adaptacyjna kompresja widma i granice dialogu dla 11,8 dB DnR
Intensywna lektura pracy dyplomowej / separacja dźwięku filmowego i telewizyjnego
LEKTURA PRACY / SEPARACJA FILMOWA
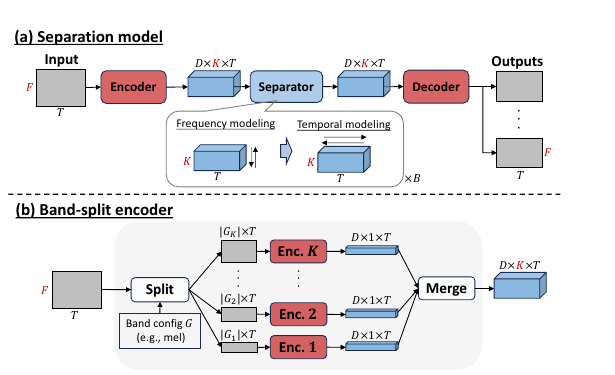
DnR rozdziela miks programu na dialogi, muzykę i efekty. Te źródła nakładają się w czasie i w częstotliwości, więc zadania nie da się sprowadzić do detekcji aktywności mowy. SFC-Locoformer, BandIt i TIGER-DnR podejmują to samo zadanie, różniąc się schematami kompresji, kosztem sekwencji i opublikowanymi dowodami.
Kompresja widmowa
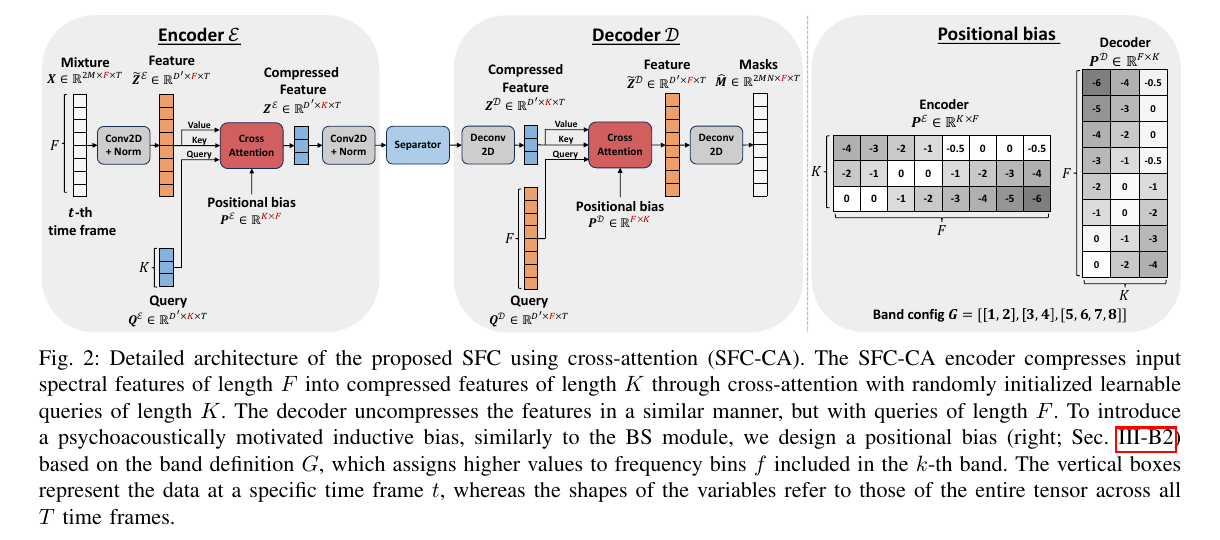
STFT daje widmo zespolone X(t,f). Przydzielanie każdemu sąsiedniemu prążkowi tego samego budżetu kanałów marnuje moc obliczeniową na silnie skorelowane cechy. SFC uczy się projekcji na zwartą oś widmową:
Z(t,k)=Σ_f C(k,f)·[Re X(t,f), Im X(t,f)]
Dekoder używa uwagi krzyżowej, by przywrócić skompresowaną reprezentację do docelowych prążków częstotliwości. Nie jest to cięcie wysokich tonów: stany przejściowe spółgłosek, podtrzymane harmoniczne i szerokopasmowe efekty pozostają dostępne dla separatora.
Kontekst lokalny i dalekozasięgowy
Bloki lokalne modelują uderzenia, spółgłoski wybuchowe i ataki perkusji; wymiana między oknami przenosi podkłady muzyczne, zdania i otoczenie. Jedno gęste pole uwagi sprawiłoby, że pamięć rosłaby gwałtownie wraz z czasem trwania. Locoformer łączy mieszanie lokalne z oszczędną wymianą dalekozasięgową, dzięki czemu opublikowany checkpoint medium pozostaje praktyczny.
Jak poprawnie czytać 11.8 dB
Tabela II podaje 11.8 dB dla SFC-Locoformer medium i 10.9 dB dla BandIt w tym samym protokole testowym DnR. Cel niezmienniczy względem skali ma postać:
SI-SDR=10 log10(||s_target||² / ||e_noise||²)
Wynik uzasadnia ranking w obrębie protokołu, a nie porównania z MUSDB, inną rewizją DnR czy ręcznie wybranymi klipami. Przewaga 0.9 dB nie gwarantuje też zwycięstwa na każdym fragmencie filmu; spółgłoski szczelinowe, szerokość otoczenia i stany przejściowe efektów nadal wymagają ślepego odsłuchu.
Opublikowany kod i wagi
Autorzy publikują enkodery SFC-CA, SFC-Mamba i BandIt, separator TF-Locoformer oraz wstępnie wytrenowane wagi MUSDB18-HQ i DnR. Architekturę z pracy, implementację z repozytorium i pliki kart modeli można więc wzajemnie ze sobą weryfikować; 11.8 dB wciąż należy wyłącznie do protokołu DnR v2 z tabeli II.
Od benchmarku DnR do skompresowanych widm
Separacja dialogów, muzyki i efektów zyskała względnie stabilną definicję celu po wyzwaniu DnR Challenge z 2021 roku. BandIt skupił później zdolność modelowania na niejednorodnych pasmach częstotliwości, a TIGER zbadał tańszy model sekwencyjny. SFC-Locoformer stawia inne pytanie inżynieryjne: skoro sąsiednie prążki częstotliwości są nadmiarowe, czy można je skompresować, zanim budżet modelu zostanie wydany na dłuższą strukturę dialogów i ścieżki muzycznej?
Ta historia sprawia, że trzy opublikowane modele można zestawić na jednej stronie zadania, nie opisując ich jako prostego zastąpienia starego nowym. BandIt to silna linia bazowa z podziałem pasm, TIGER oferuje alternatywę zorientowaną na koszt obliczeń, a opublikowany checkpoint SFC medium raportuje 11.8 dB w tym samym protokole DnR v2, którego używa tabela II. Liczy się architektura, liczą się wagi, liczy się też protokół ewaluacji.
Kompresja widmowa jako operator adaptacyjny
Z(t,k)=Σ_f A(k,f|X)·W_f·X(t,f)X(t,f)zespolone widmo wejścioweA(k,f|X)agregacja pasm adaptowana do wejściaZ(t,k)skompresowana reprezentacja sekwencji
A nie jest sztywną regułą przycinania częstotliwości. To zależna od wejścia waga agregacji, więc krótsza oś k zostawia więcej zdolności sekwencyjnej dialogom, ścieżce muzycznej i otoczeniu w czasie.
Dekoder nadal odpytuje cechami nieskompresowanymi, by odtworzyć każdy prążek wyjściowy. Równanie jest abstrakcją przepływu informacji; CrossAttnEncoder, CrossAttnDecoder i adaptacyjne zapytanie w repozytorium stanowią implementację, którą można audytować.
Pracę, kod i wagi można śledzić przez SFC-Locoformer source / Released DnR checkpoint / SFC paper and DnR table.
Jak daleko sięga wspólna tabela
Zestawiono tu tylko wiersze zweryfikowane w tym samym opublikowanym protokole; TIGER-DnR nie jest wstawiany do tabeli II bez pasującego wyniku.
| Model | Opublikowany wynik | Jak to czytać |
|---|---|---|
| SFC-Locoformer medium | 11.8 dB SI-SDR | najwyższa opublikowana wartość w tym protokole; krawędzie dialogów nadal do audytu |
| BandIt | 10.9 dB SI-SDR | linia bazowa z podziałem pasm w tym samym protokole |
| TIGER-DnR | dowody efektywności pokazane osobno | nie domieszany do brakującego wiersza tabeli |
Trzy kontrole odsłuchowe poza wynikiem średnim
W dialogach wsłuchuj się w sybilanty, oddechy i mowę z dali. SI-SDR usuwa globalne wzmocnienie z porównania, ale może przeoczyć metaliczne krawędzie i zniszczone ogony pomieszczenia. W muzyce sprawdzaj, czy nie ma duchów mowy; w efektach pilnuj ciągłości drzwi, kroków i otoczenia.
Miksy nadawcze zawierają też limitowanie, ducking dialogów i zwijanie kanałów. Protokół z pracy DnR nie reprezentuje automatycznie każdego mastera dystrybucyjnego; porównania SFC, BandIt i TIGER powinny używać tych samych fragmentów i osobno audytować krawędzie dialogów, przecieki muzyki oraz ciągłość otoczenia.
Model nie rozpoznaje każdego obiektu w scenie
Ścieżka efektów to szeroki pojemnik. Deszcz, ruch uliczny, brawa i foley pozostają złożone w całość, więc wynik DnR nie jest dekompozycją dźwięku na poziomie obiektów.
Warunki licencji nadrzędnych nadal rządzą wdrożeniem i redystrybucją, nawet jeśli forma zadania nie przerywa już pracy wykładem o licencji modelu.
Prace i publiczne pliki dla źródła SFC-Locoformer
Nazwy modeli, liczby i ograniczenia można wyśledzić w pracach, repozytoriach lub kartach modeli poniżej.