모델
HQ-SVC 및 YingMusic-SVC: 노래 음성 변환의 콘텐츠, F0, 에너지 및 음색을 분해합니다.
가창성변환 / 기술비교
가창성변환 / 기술비교
가창 음성 변환
SVC는 목표 참조를 소스에 섞는 기술이 아니다. 소스의 가사, 타이밍, 멜로디를 유지하면서 음색 통계를 교체해야 한다. 콘텐츠 누출은 발음 오류나 배경음 유입으로 나타난다.
음높이는 반음 단위로 p=69+12log₂(f₀/440)와 같이 나타낼 수 있다. 자동 음역 이동은 음역 차이가 클 때 도움이 되지만 F0 오류는 슬라이드, 호흡, 화음을 잘못된 멜로디 단서로 바꾼다.
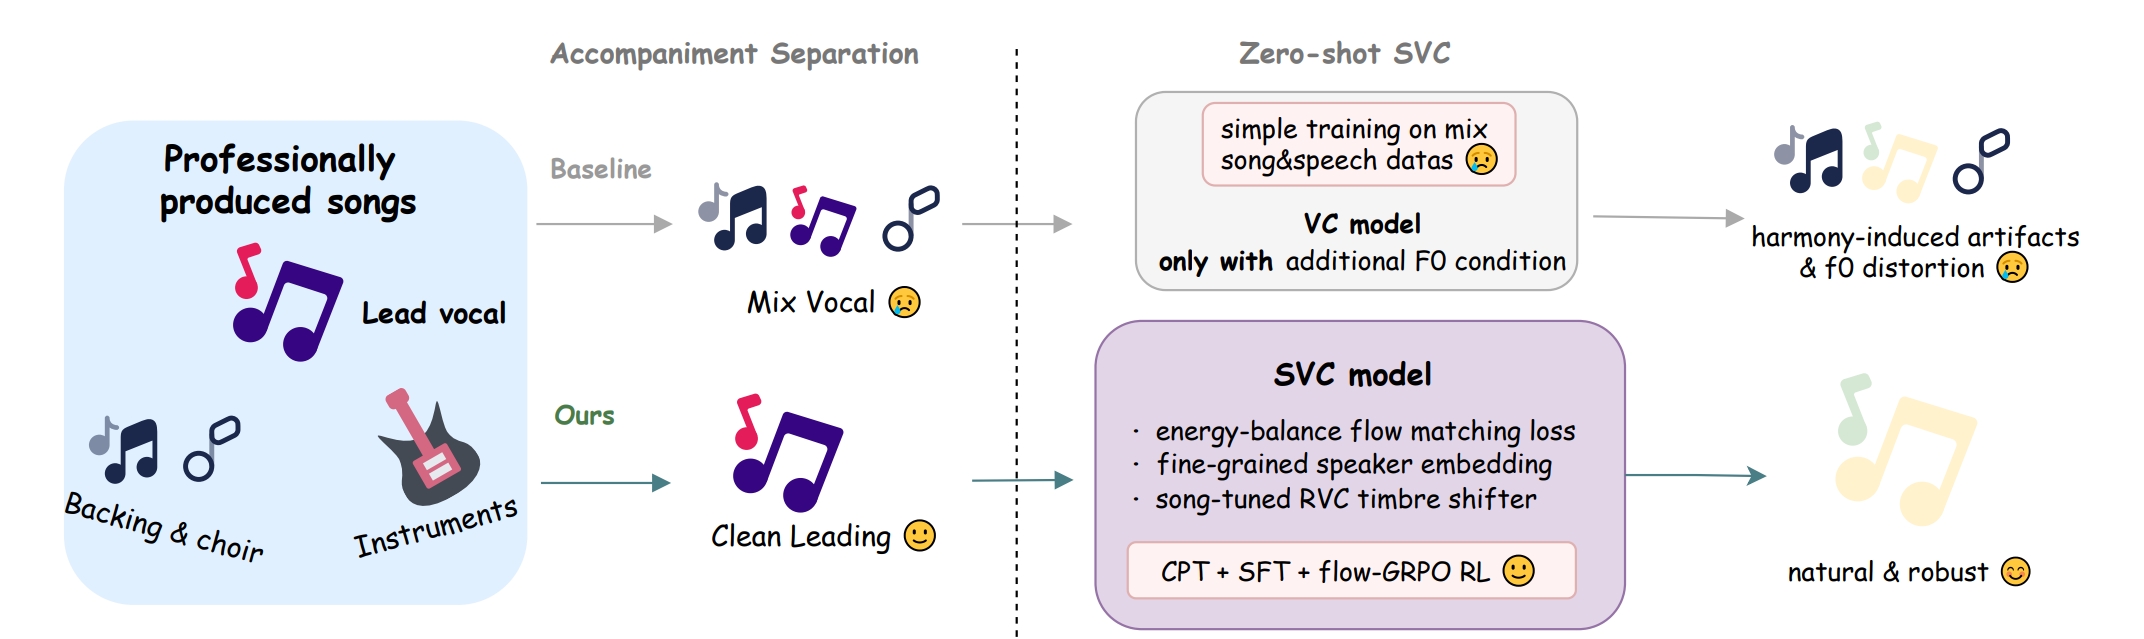
HQ-SVC 모델 카드에는 추론 코드, FACodec, RMVPE, 보코더 자산이 함께 제공된다. YingMusic-SVC는 F0 인식 어댑터, 에너지 균형 흐름 매칭, 실제 환경의 화음 오염을 위한 학습 방식을 공개한다. 공통 테스트 세트가 없으므로 공개 자료만으로 두 프로젝트 중 하나를 승자로 정할 수는 없다.
소스의 반주 누출은 변환 과정에서 다시 착색되고, 목표 프롬프트의 리버브나 배경음은 정체성으로 오인될 수 있다. 리드 보컬 소스와 목표 참조는 모두 깨끗해야 하며 변환된 오디오는 합성물임을 명확히 밝혀야 한다.
가창 음성 변환은 한 연주의 가사와 멜로디를 유지하면서 음색 관련 표현을 교체한다. HQ-SVC는 고품질 변환 체인을 강조하고, YingMusic-SVC는 콘텐츠, F0, 화자 조건을 다루는 또 다른 설계를 제시한다. 합성과 달리 입력은 이미 존재하는 가창 연주다.
SVC는 스펙트럼 매핑에서 콘텐츠 인코더, 명시적 F0, 생성형 디코더, 더 강력한 화자 표현으로 발전했다. 분리는 여전히 불완전하다. 소스의 억양, 강약, 포먼트가 유출될 수 있고 목표 참조의 공간음도 복사될 수 있다.

ŷ=G(c(x_src),F0(x_src),E(x_src),e(x_ref))c(x_src)언어 콘텐츠F0,E멜로디와 에너지e(x_ref)목표 음색 조건콘텐츠, F0, 에너지는 소스 연주에서 나오고 목표 음색은 참조에서 가져온다. 분리가 불완전하면 소스의 정체성이 남거나 공간 착색이 전이된다.
전체 믹스는 먼저 깨끗한 리드 보컬 stem으로 분리해야 한다. 분리 누출은 변환 과정에서 다시 착색되어 제거하기 더 어려워질 수 있으므로 두 단계를 함께 점검해야 한다.
논문, 코드, 가중치는 HQ-SVC / YingMusic-SVC / YingMusic-SVC 논문에서 확인할 수 있다.

각 행은 원 출처의 아키텍처, 지표 또는 과업 정의를 유지하며, 공통 프로토콜이 없는 결과는 분리해 제시한다.
| 모델 | 아키텍처 또는 근거 | 범위 |
|---|---|---|
| HQ-SVC | 고품질 기본 체인 | 충실도, 명료도, 고음역 안정성 |
| YingMusic-SVC | 콘텐츠/F0/음색 비교 | 가수 및 언어 간 보존 |
| 소스 분리 + SVC | 믹스 입력을 위한 전체 경로 | 분리 누출이 변환으로 전파됨 |
가사와 리듬을 먼저 확인한 뒤 음높이 도약, 치찰음, 숨소리, 고음역 끊김을 살펴본다. 자동 조옮김은 발성 부담을 바꾸므로 평균 유사도만으로 요약할 수 없다.
목표 참조는 건조하고 독창이며 반주가 없고 유용한 음역을 포함해야 한다. 짧고 잔향이 많은 샘플은 공간 착색을 정체성처럼 보이게 할 수 있다.
변환은 저작권이나 실연자의 권리를 없애지 않는다. 공개하려면 소스 연주와 목표 정체성 모두에 대한 허가가 필요하다.
시스템은 익명화를 보장하지 않는다. 소스 특성이 남을 수 있으므로 SVC는 개인정보 보호 필터가 아니다.
모델명, 수치, 제한 사항은 아래 논문, 저장소 또는 모델 카드에서 확인할 수 있다.