Google Magenta RealTime 2: 음악 모델이 연주 가능한 악기로 바뀌는 순간
MRT2의 40ms 프레임 단위 자기회귀, 저지연 MIDI/텍스트/오디오 제어, 2.4B/230M 모델 구성, SpectroStream codec 경로, MusicCoCa 스타일 임베딩, 실시간 연주 경계를 정리한 기술 백서형 글입니다.
모델 소식 / Google Magenta
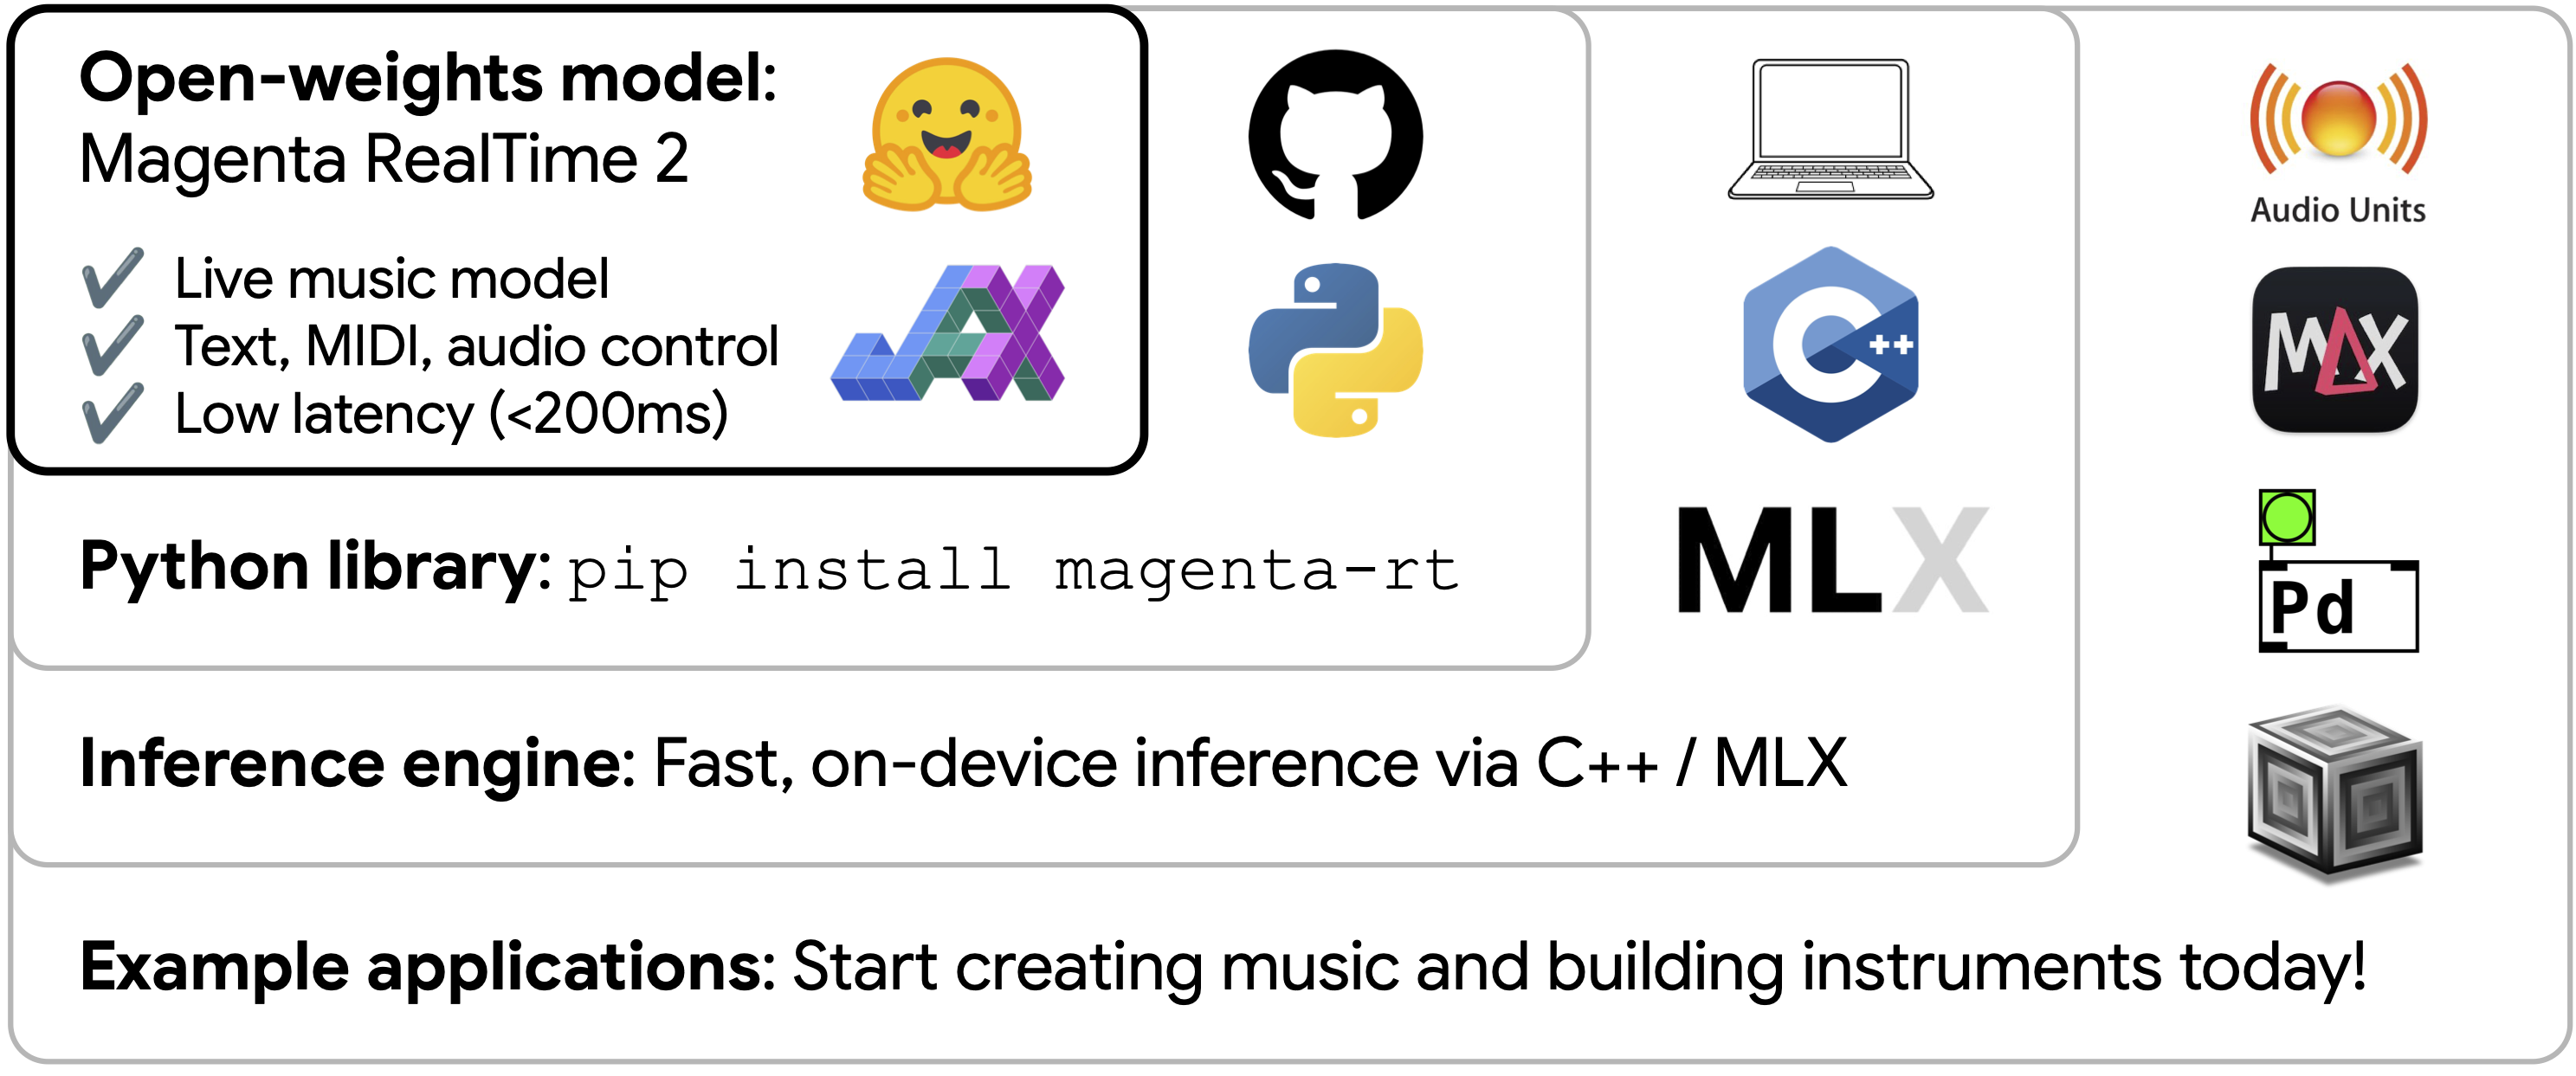
Google Magenta RealTime 2 (MRT2)는 기존의 “prompt를 입력하고 완성된 트랙을 기다리는” 음악 생성기가 아니다. Google은 이를 오픈 모델, 실시간 inference engine, 예제 애플리케이션의 결합으로 설명한다. 2.4B 파라미터 기본 모델, 230M 파라미터 소형 모델, SpectroStream 오디오 코덱, MusicCoCa 스타일 표현, MIDI/텍스트/오디오 제어, 로컬 실시간 음악 생성 환경으로 구성된다.
이 개정 기사에는 MRT2의 독특한 위치를 설명하기 위해 Google 공식 도표와 model card 근거를 더했다. 편곡, mixing 또는 전체 곡 제작을 대체하려는 모델이 아니다. 음악 모델을 연주 가능하고 제어하기 쉬우며 DAW에 친화적인 실시간 상호작용으로 밀어붙인다. 실제로는 오프라인 곡 생성기보다 실시간 협업자에 더 가깝다.
Magenta RealTime과 Lyria RealTime API에서 연주 가능한 로컬 모델로
MRT2는 같은 연구 프로그램의 앞선 두 갈래인 Magenta RealTime 모델과 호스팅형 Lyria RealTime API를 잇는다. 이 시스템들은 연속 생성과 조절 가능한 음악 style을 확립했지만, 이전 모델은 약 2초 frame을 사용하는 chunk 단위 자기회귀 방식이었다. note, style 변경 또는 새 참조 오디오는 현재 chunk가 끝날 때까지 소리에 영향을 줄 수 없었다.
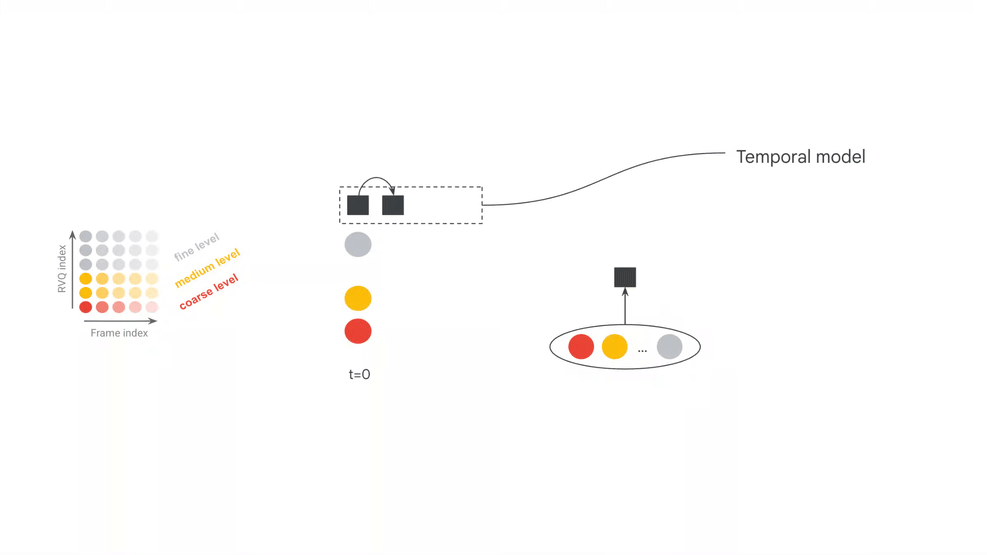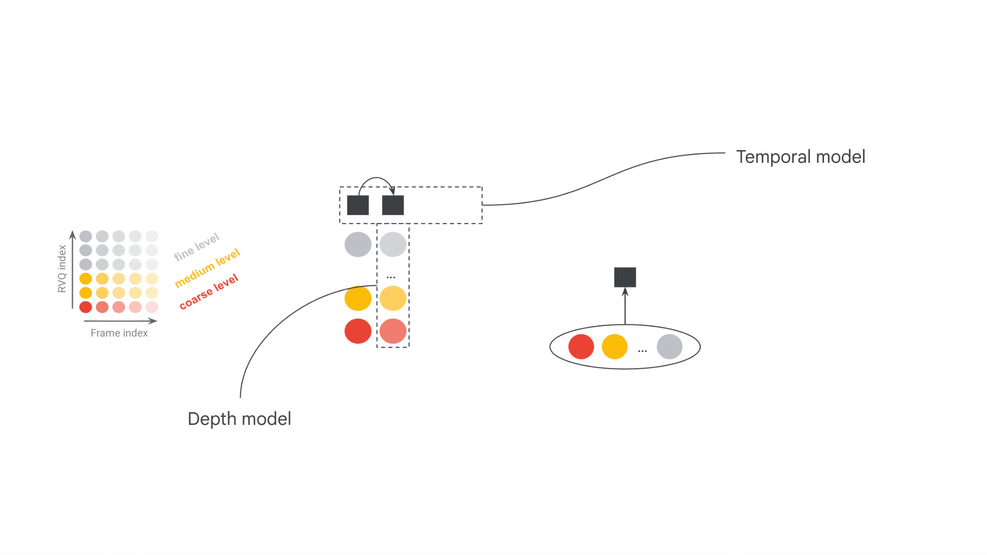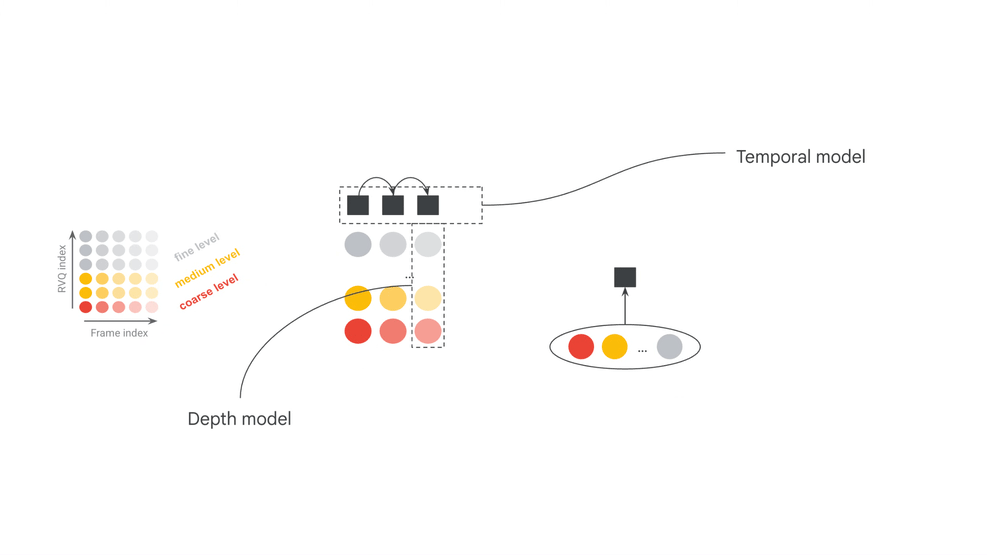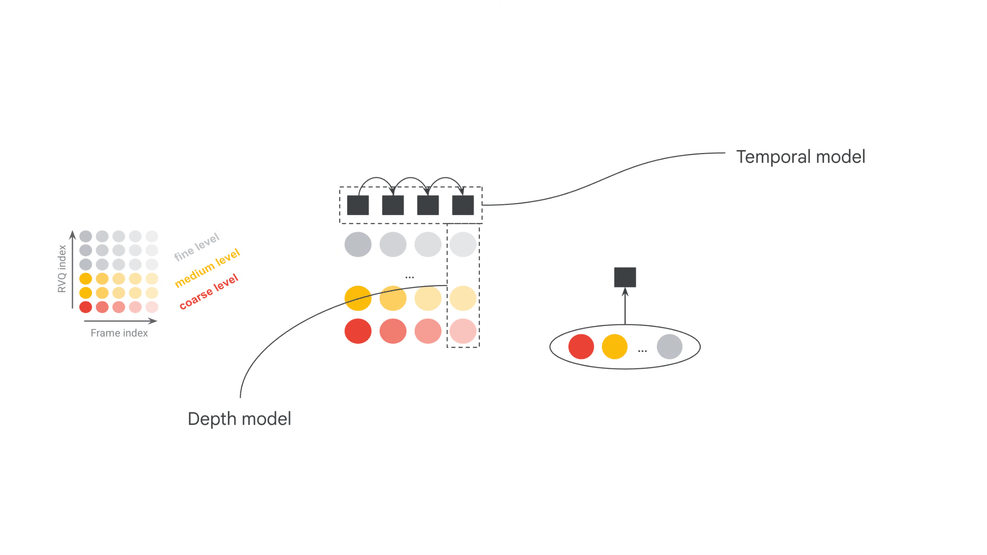
MRT2는 SpectroStream과 MusicCoCa를 유지하면서 생성 backbone을 frame 단위로 자기회귀하는 decoder-only Transformer로 바꿨다. 이제 frame은 40 ms이며, 새 frame마다 MIDI 상태, style token, audio context를 다시 읽는다. Google이 보고한 제어 지연 시간은 약 3초에서 약 200 ms로 줄었다. 예전에는 하나의 chunk를 만들던 2초 동안 새 모델은 소리의 방향을 바꿀 기회를 50번 갖는다.
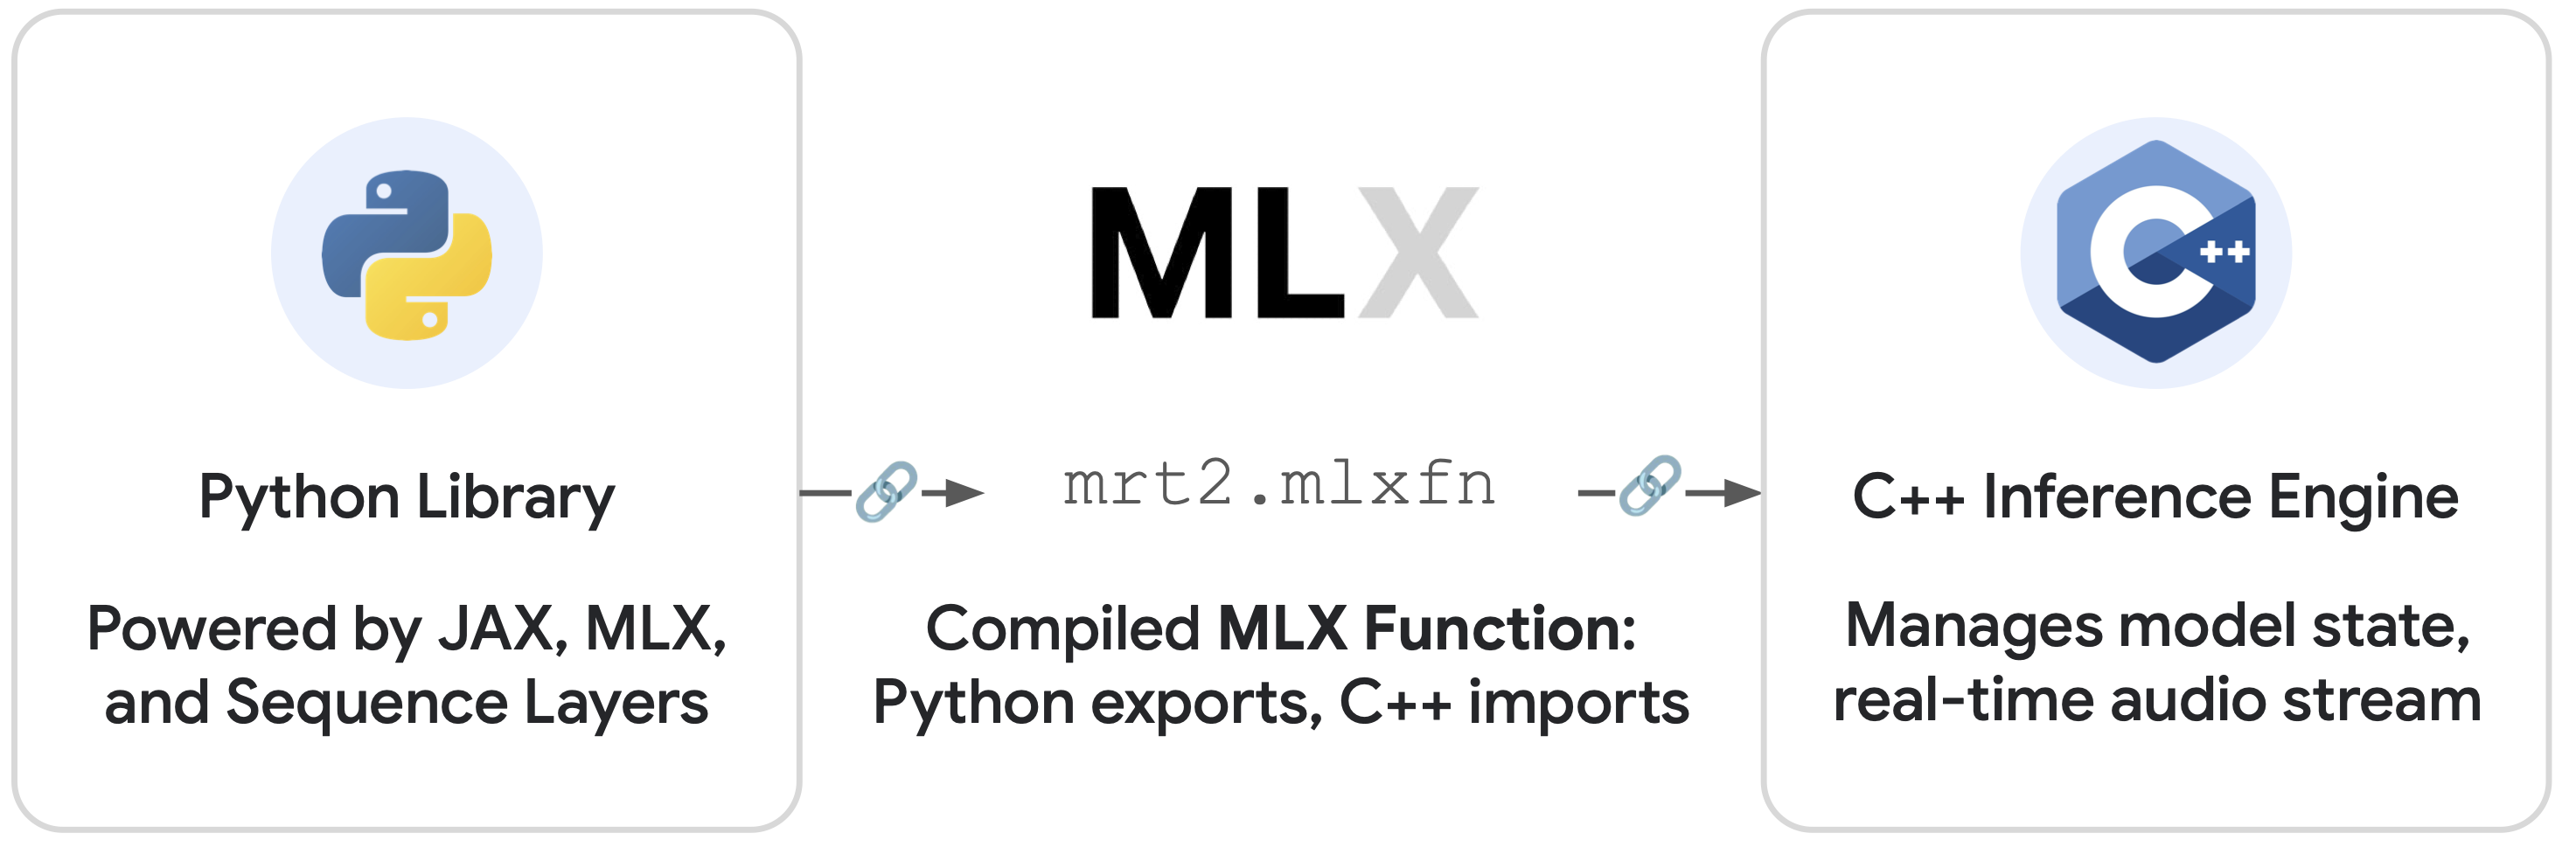
이 릴리스는 호스팅형 시연과 음악가가 자신의 도구 안에 넣을 수 있는 모델도 분리한다. Lyria RealTime API가 서비스형 상호작용 생성을 보여 줬다면, MRT2는 기기 내 사용을 위한 weight, Python library, MLX C++ engine, DAW 예제, standalone 애플리케이션을 공개한다. 상호작용을 prompt 입력, 대기, 다운로드로 축소하지 않고 공연 설정, 게임 soundtrack 시스템 또는 installation 안에 배치할 수 있다.
기술적 근거: 단순히 더 큰 모델이 아니다
공식 model card는 MRT2를 SpectroStream, MusicCoCa, decoder-only Transformer LLM이라는 세 핵심 구성 요소로 나눈다. SpectroStream은 48kHz stereo 음악 오디오를 token으로 변환하는 discrete audio codec이다. MusicCoCa는 텍스트와 음악 오디오를 하나의 공유 embedding space로 mapping한다. LLM은 문맥 오디오 token, MusicCoCa 스타일 token, MIDI token을 조건으로 다음 audio frame을 생성한다.
이 구조는 MRT2가 텍스트, 오디오, MIDI를 동시에 받을 수 있는 이유를 설명한다. 텍스트는 style을 기술하고, 오디오는 음색 또는 음악적 참조를 제공하며, MIDI는 연주 상태를 제어한다. 입력을 단순히 이어 붙이는 것이 아니라 실시간 생성 loop 안에서 서로 다른 역할을 맡긴다.
공식 모델 구성 두 가지도 의미가 있다. 2.4B-parameter base model과 230M-parameter small model이다. base model은 품질에 더 무게를 두고, small model은 로컬 실행의 문턱을 낮춘다. model card에는 base의 25-frame (1s) windowed attention, small의 41-frame (~1.6s) windowed attention, 두 모델 모두의 20s effective receptive field도 기재돼 있다. 이는 제한된 context를 사용하는 연속 생성이지, 곡 전체를 대상으로 하는 오프라인 reasoning이 아니다.
낮은 지연 시간이 실제로 뜻하는 것
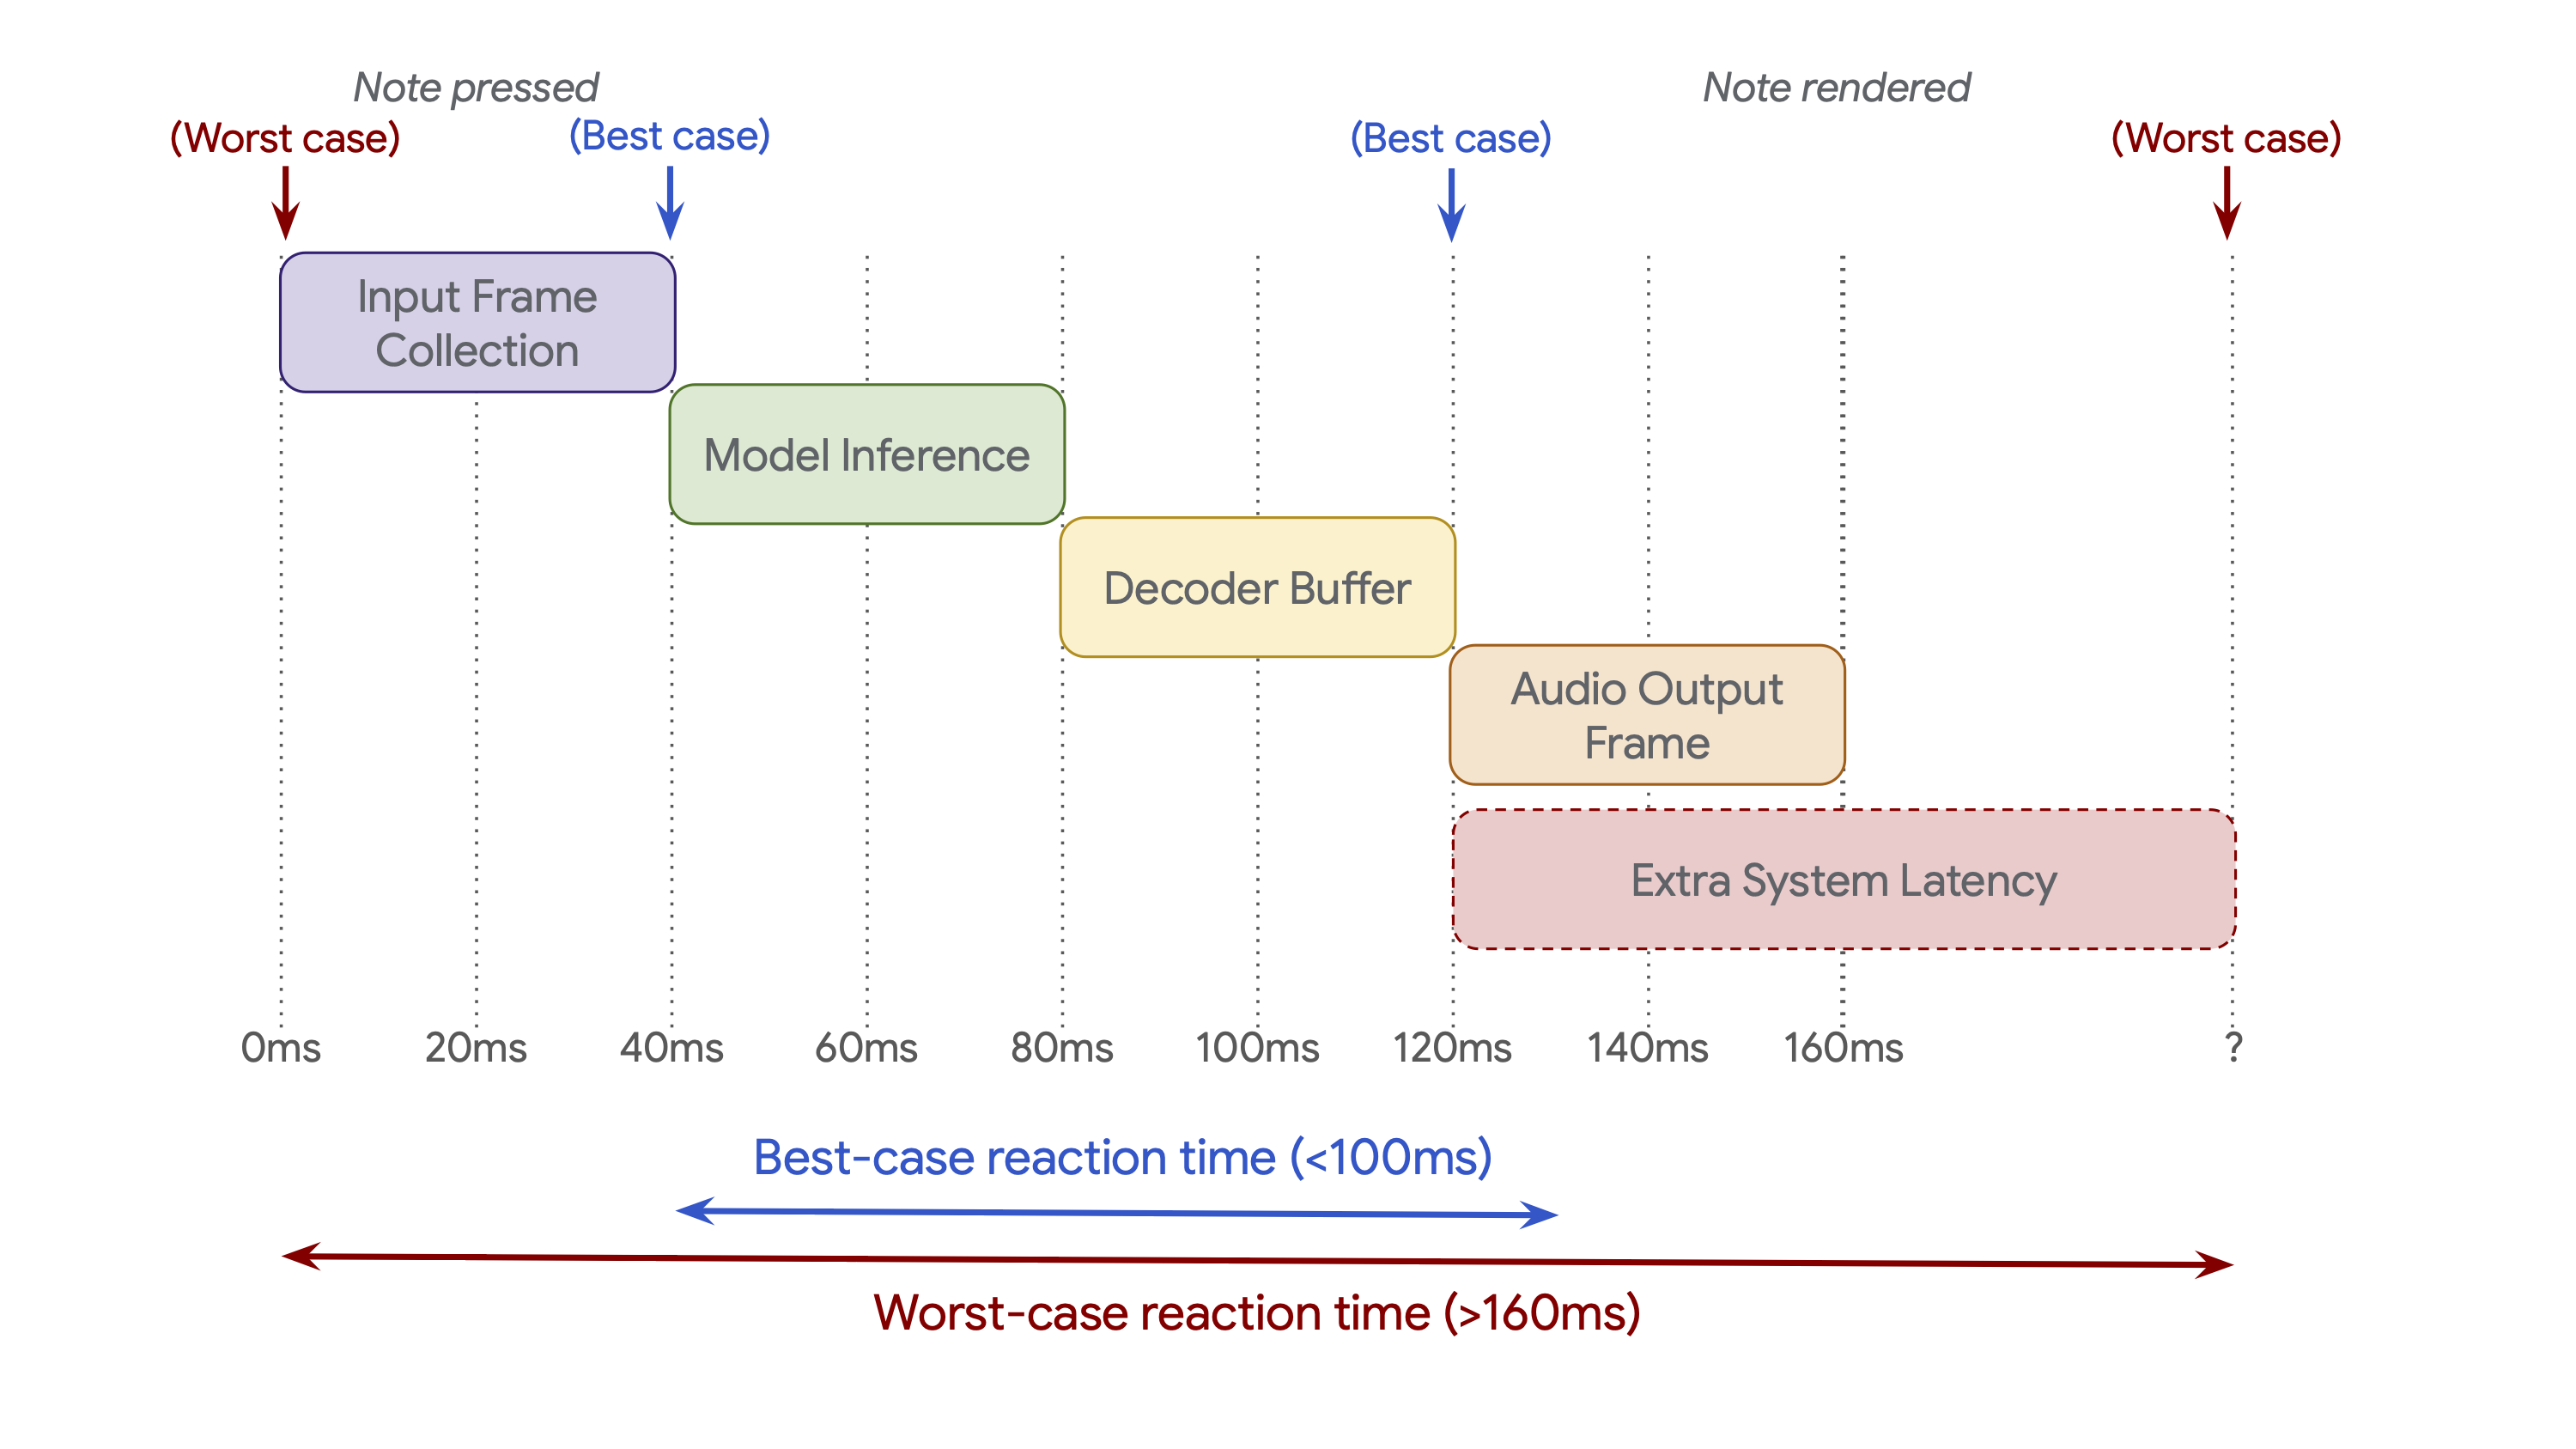
Google이 내세운 주요 변화 중 하나는 이전 세대와 비교해 모델 frame 크기를 2s에서 40ms로 줄이고, 제어 지연 시간을 약 3s에서 약 200ms로 단축한 것이다. 매력적인 수치지만 공식 범위를 함께 봐야 한다. end-to-end 반응 시간은 모델 inference만으로 결정되지 않는다. 입력 buffer, 출력 buffer, audio interface, host software, 외부 component도 포함한다.
음악가에게 약 200ms는 hardware keyboard나 drum trigger처럼 거의 즉각적인 반응이 아니다. 하지만 모델을 “오프라인 생성기”에서 “상호작용 시스템”으로 옮기기에는 충분하다. MRT2는 밀리초 단위로 정확한 drum machine이나 piano instrument의 대체재라기보다 style morphing, 반주 확장, texture response, live coding, installation, game music에 맞는 모델로 보는 편이 타당하다.
일회성 곡 생성과 다른 점
| 관점 | Magenta RealTime 2 | 일반적인 prompt-to-track 생성기 | 실용적 영향 |
|---|---|---|---|
| 상호작용의 리듬 | 듣고, 연주하고, 조정하면서 생성을 이어 간다. | prompt를 입력하고 완성된 결과를 기다린다. | MRT2는 실시간 실험과 공연에, prompt-to-track은 빠른 완성 초안에 어울린다. |
| 제어 입력 | MIDI, 텍스트, 오디오를 함께 사용한다. | 대개 텍스트 prompt와 제한된 구조 제어를 사용한다. | MIDI를 통해 모델이 연주 gesture에 반응할 수 있다. |
| 실행 위치 | 공식적으로 로컬, 오픈 weight, Apple Silicon 앱, DAW 플러그인을 중심으로 설명된다. | 클라우드 호스팅 서비스인 경우가 많다. | MRT2는 연구, 플러그인, 로컬 음악 software 통합에 더 자연스럽지만 로컬 hardware가 필요하다. |
| 출력 목표 | 계속 조절할 수 있는 연속적인 음악 오디오. | 완성된 곡 또는 완성된 clip. | MRT2는 완성곡 공장보다 실시간 악기나 반주자처럼 동작한다. |
| 창작의 경계 | model card는 instrumental music에 집중하며 비어휘적 발성음의 한계를 명시한다. | 보컬 곡 생성을 중심으로 홍보되는 경우가 많다. | MRT2는 instrumental, texture, 반주, 상호작용 음악 장면에 적합한 것으로 이해해야 한다. |
MRT2 공식 자료의 핵심 사실
| 관점 | 공식 자료 | 정확한 해석 |
|---|---|---|
| 라이선스 | 코드는 Apache-2.0, 모델 weight는 CC-BY 4.0. | 단일 라이선스 릴리스가 아니다. 통합할 때 코드, weight, 사용 조건을 함께 읽어야 한다. |
| 모델 구분 | 2.4B base / 230M small. | base와 small은 품질과 로컬 실행에서 서로 다른 tradeoff를 나타낸다. |
| Audio codec | SpectroStream은 48kHz stereo audio를 25Hz frame rate, 64 RVQ depth, 10-bit code, 16kbps의 token으로 변환한다. | 실시간 동작은 sample rate 하나가 아니라 모델과 codec/streaming representation의 결합에서 나온다. |
| 제어 입력 | 텍스트 prompt, 오디오 예시, MIDI. | 세 입력은 각각 style, context, 연주 상태 제어를 나타낸다. |
| 학습 데이터 | 대부분 instrumental인 약 71k시간의 stock music. | 보컬 가사에 대한 기대는 신중해야 한다. model card는 발성음이 비어휘적인 경향을 명시한다. |
| 평가 | model card는 향후 technical report에서 metric과 결과를 공유한다고 밝힌다. | leaderboard나 미공개 점수를 만들어 내지 말고, 공개된 아키텍처와 한계만 인용해야 한다. |
이 릴리스가 상호작용 음악에 가져온 변화
MRT2의 핵심어는 연속 생성과 낮은 지연 시간 제어다. prompt로 명령만 하는 것이 아니라 연주하고 방향을 조절하도록 설계됐다.
model card는 상호작용 음악 제작과 대부분 instrumental인 stock music을 중심으로 한다. 완성곡, 가사, 보컬, 출시 가능한 제작에는 여전히 사람의 workflow가 필요하다.
오픈 weight와 로컬 inference는 연구, 플러그인, DAW 통합을 더 현실적으로 만들지만 hardware, buffer, host software, audio interface가 모두 경험을 좌우한다.
이 기사에 사용된 이미지와 GIF는 모두 Google Magenta의 공식 릴리스 자산이며, 대체 그림이나 다시 만든 chart가 아니다.