Модель
HQ-SVC і YingMusic-SVC: демонтаж перетворення змісту, F0, енергії та тембру голосу співу
Перетворення голосу співу / Порівняння технологій
Перетворення голосу співу / Порівняння технологій
ПЕРЕТВОРЕННЯ СПІВАЦЬКОГО ГОЛОСУ
SVC не підмішує цільовий референс до джерела. Система має зберігати слова, часову структуру й мелодію джерела, замінюючи статистичні характеристики тембру. Витік вмісту перетворюється на помилки вимови або проникнення фонового звуку.
Висоту тону можна виразити в півтонах як p=69+12log₂(f₀/440). Автоматичне зміщення діапазону допомагає за значної різниці регістрів, але помилки F0 перетворюють глісандо, дихання й гармонію на хибні мелодичні сигнали.
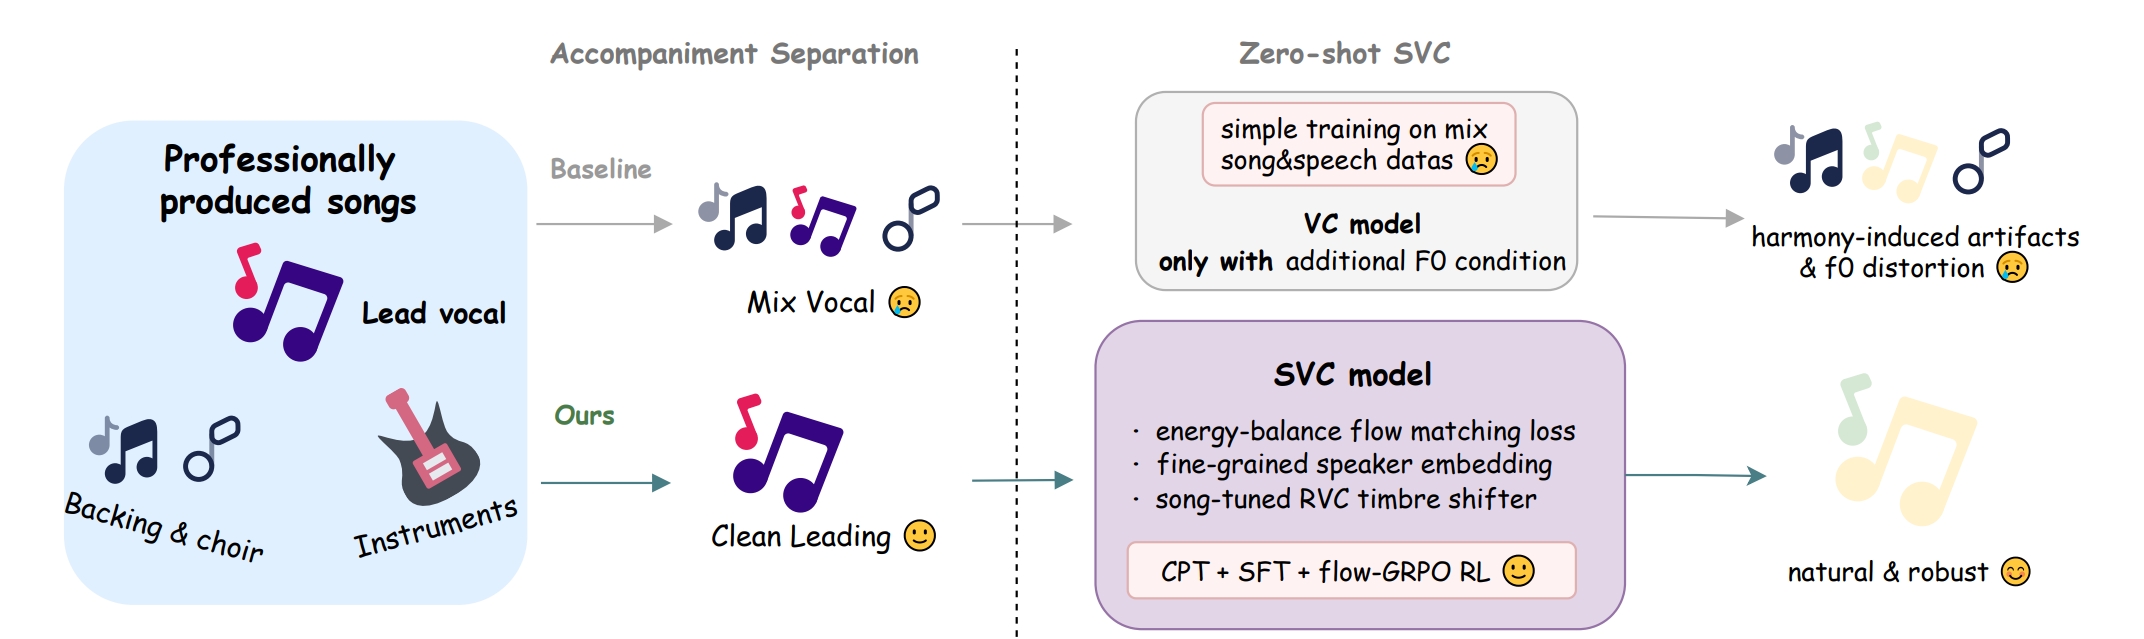
Картка моделі HQ-SVC містить код інференсу, FACodec, RMVPE й ресурси вокодера. YingMusic-SVC публікує адаптер з урахуванням F0, енергетично збалансоване узгодження потоків і навчання на гармонічних домішках у реальних записах. Без спільного тестового набору публічні матеріали не дають підстав визначити єдиного переможця між проєктами.
Просочування акомпанементу в джерелі набуває нового забарвлення під час перетворення, тоді як реверберацію або фоновий звук у цільовому зразку можна помилково сприйняти як частину ідентичності. І джерело з провідним вокалом, і цільовий референс мають бути чистими, а перетворений звук потрібно чітко позначати як синтетичний.
Перетворення співацького голосу зберігає слова й мелодію виконання, замінюючи пов'язане з тембром представлення. HQ-SVC зосереджується на високоякісному ланцюжку перетворення; YingMusic-SVC пропонує іншу схему обумовлення вмістом, F0 і співаком. На відміну від синтезу, вхідними даними є вже наявне вокальне виконання.
SVC розвинувся від спектрального відображення до кодувальників вмісту, явного F0, генеративних декодерів і сильніших представлень співака. Розділення досі неповне: акцент, динаміка й форманти джерела можуть просочуватися, а звук приміщення з цільового референсу — копіюватися.

ŷ=G(c(x_src),F0(x_src),E(x_src),e(x_ref))c(x_src)мовний вмістF0,Eмелодія й енергіяe(x_ref)умова цільового тембруВміст, F0 та енергія надходять із вихідного виконання; цільовий тембр — із референсу. Неповне розділення залишає ідентичність джерела або переносить забарвлення приміщення.
Для повного міксу спочатку потрібен чистий стем провідного вокалу. Просочування після розділення набуває нового забарвлення під час перетворення, і його може бути складніше усунути, тому обидва етапи слід перевіряти разом.
Статті, код і ваги доступні через HQ-SVC / YingMusic-SVC / статтю YingMusic-SVC.

Кожен рядок зберігає архітектуру, метрику або визначення завдання зі свого джерела; результати без спільного протоколу розглядаються окремо.
| Модель | Архітектура або свідчення | Сфера оцінювання |
|---|---|---|
| HQ-SVC | стандартний ланцюжок високої якості | точність відтворення, чіткість і стабільність високого регістру |
| YingMusic-SVC | порівняння вмісту/F0/тембру | збереження між співаками й мовами |
| розділення джерел + SVC | повний шлях для міксованого входу | просочування від розділення переходить у перетворення |
Спочатку перевірте слова й ритм, потім стрибки висоти, сибілянти, придиховість і зриви у високому регістрі. Автоматичне транспонування змінює вокальне навантаження, і його не можна звести до середньої подібності.
Використовуйте сухий сольний цільовий референс без акомпанементу, що охоплює корисний діапазон. Короткий зразок із реверберацією може перетворити забарвлення приміщення на уявну ідентичність.
Перетворення не скасовує авторських або виконавських прав. Публічне поширення потребує дозволу і на вихідне виконання, і на цільову ідентичність.
Система не гарантує анонімізації; риси джерела можуть зберігатися, тому SVC не є фільтром приватності.
Назви моделей, числа й обмеження походять із наведених нижче статей, репозиторіїв або карток моделей.