โมเดล
HQ-SVC และ YingMusic-SVC: การแยกเนื้อหา, F0, พลังงานและจังหวะของการแปลงเสียงร้องเพลง
การเปรียบเทียบการแปลงเสียง/เทคโนโลยีการร้องเพลง
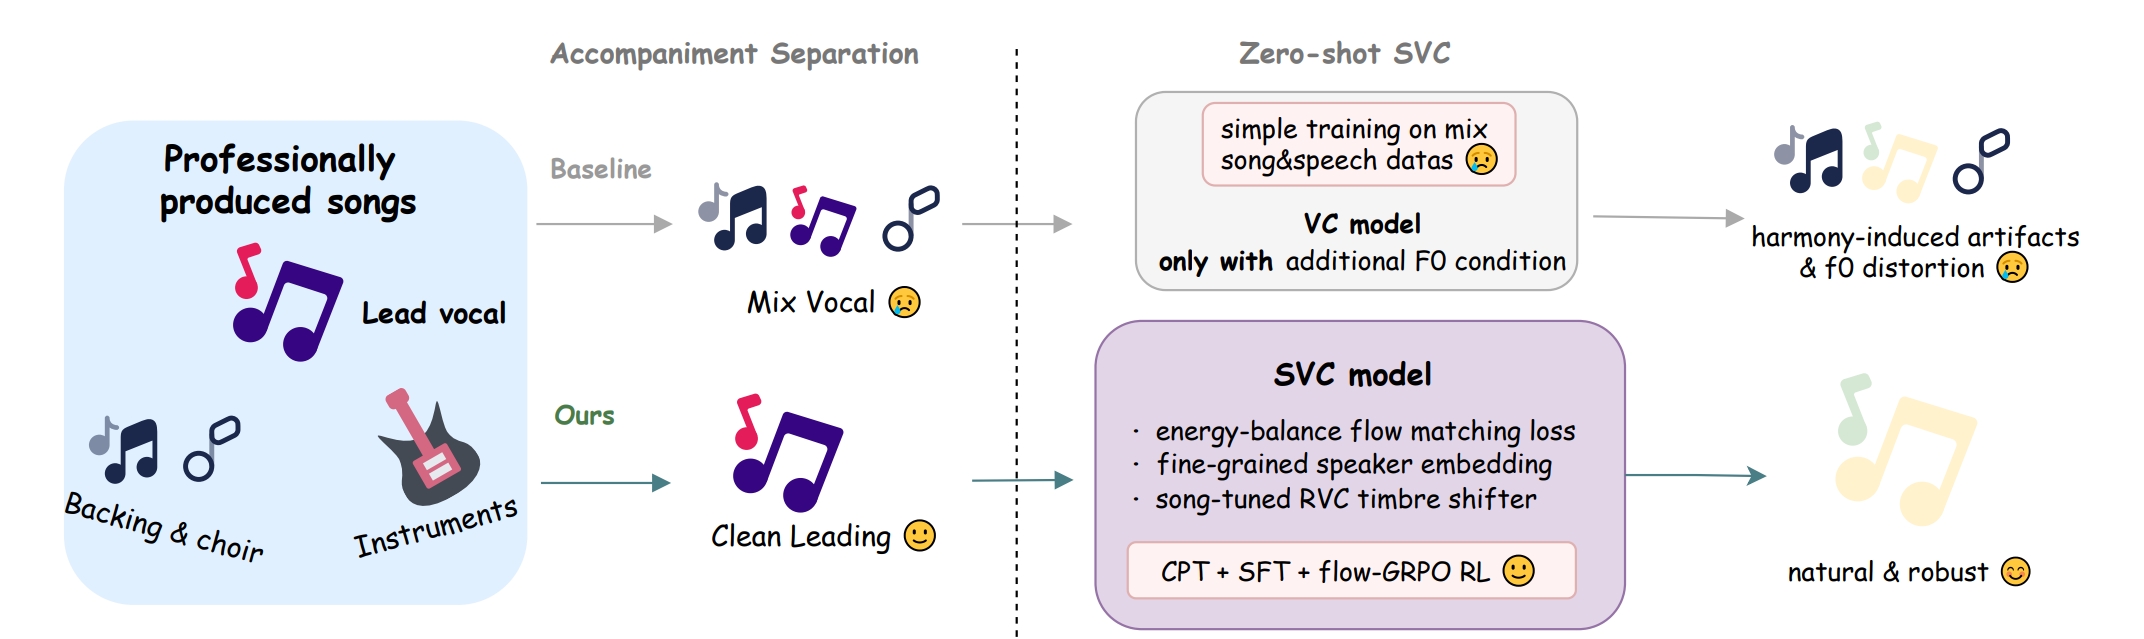
การเปรียบเทียบการแปลงเสียง/เทคโนโลยีการร้องเพลง
การแปลงเสียงร้อง
SVC ไม่ได้นำเสียงอ้างอิงเป้าหมายมาผสมกับเสียงต้นทาง ระบบต้องรักษาเนื้อร้อง จังหวะเวลา และทำนองของต้นทางไว้ พร้อมกับเปลี่ยนค่าสถิติของลักษณะเสียง การรั่วไหลของเนื้อหาจะกลายเป็นความผิดพลาดในการออกเสียงหรือเสียงพื้นหลังที่แทรกเข้ามา
ระดับเสียงสามารถแสดงเป็นหน่วยครึ่งเสียงได้ตาม p=69+12log₂(f₀/440) การเลื่อนช่วงเสียงอัตโนมัติช่วยเมื่อช่วงเสียงแตกต่างกันมาก แต่ข้อผิดพลาดของ F0 จะเปลี่ยนการไล้เสียง ลมหายใจ และเสียงประสานให้เป็นสัญญาณทำนองที่ผิด
การ์ดโมเดล HQ-SVC รวมโค้ดอนุมาน FACodec, RMVPE และทรัพยากรโวโคเดอร์ไว้ด้วยกัน ส่วน YingMusic-SVC เผยแพร่อะแดปเตอร์ที่รับรู้ F0 การจับคู่โฟลว์แบบสมดุลพลังงาน และการฝึกสำหรับการปนเปื้อนของฮาร์มอนิกในสภาพใช้งานจริง เมื่อไม่มีชุดทดสอบร่วมกัน เอกสารสาธารณะจึงไม่รองรับข้อสรุปว่ามีผู้ชนะเพียงรายเดียวระหว่างโครงการ
เสียงดนตรีประกอบที่รั่วเข้ามาในต้นทางจะถูกเปลี่ยนลักษณะเสียงไปพร้อมกับการแปลง ขณะที่เสียงก้องหรือเสียงพื้นหลังในตัวอย่างเป้าหมายอาจถูกเข้าใจผิดว่าเป็นส่วนหนึ่งของอัตลักษณ์ ทั้งแทร็กเสียงร้องนำต้นทางและเสียงอ้างอิงเป้าหมายควรสะอาด และเสียงที่แปลงแล้วต้องระบุให้ชัดเจนว่าเป็นเสียงสังเคราะห์
การแปลงเสียงร้องจะคงเนื้อร้องและทำนองจากการแสดงไว้ พร้อมกับเปลี่ยนการแทนข้อมูลที่เกี่ยวกับลักษณะเสียง HQ-SVC เน้นสายงานแปลงเสียงคุณภาพสูง ส่วน YingMusic-SVC นำเสนอการออกแบบอีกแบบที่กำหนดเงื่อนไขด้วยเนื้อหา F0 และผู้ร้อง ต่างจากการสังเคราะห์ อินพุตในกรณีนี้คือการร้องที่มีอยู่แล้ว
SVC พัฒนาจากการแมปสเปกตรัมไปสู่ตัวเข้ารหัสเนื้อหา F0 แบบชัดแจ้ง ตัวถอดรหัสเชิงกำเนิด และการแทนข้อมูลผู้ร้องที่แข็งแรงขึ้น การแยกองค์ประกอบยังไม่สมบูรณ์ สำเนียง ไดนามิก และฟอร์แมนต์ของต้นทางอาจรั่วไหล ขณะที่เสียงห้องจากเสียงอ้างอิงเป้าหมายอาจถูกคัดลอกไปด้วย

ŷ=G(c(x_src),F0(x_src),E(x_src),e(x_ref))c(x_src)เนื้อหาทางภาษาF0,Eทำนองและพลังงานe(x_ref)เงื่อนไขลักษณะเสียงเป้าหมายเนื้อหา F0 และพลังงานมาจากการร้องต้นทาง ส่วนลักษณะเสียงเป้าหมายมาจากเสียงอ้างอิง การแยกที่ไม่สมบูรณ์จะทิ้งอัตลักษณ์ของต้นทางไว้หรือถ่ายโอนลักษณะเสียงของห้องไปด้วย
เสียงมิกซ์เต็มรูปแบบต้องมีแทร็กเสียงร้องนำที่สะอาดก่อน เสียงรั่วจากการแยกจะถูกเปลี่ยนลักษณะเสียงระหว่างการแปลงและอาจกำจัดได้ยากขึ้น จึงต้องตรวจสอบทั้งสองขั้นตอนร่วมกัน
ติดตามบทความ โค้ด และน้ำหนักได้จาก HQ-SVC / YingMusic-SVC / บทความ YingMusic-SVC

แต่ละแถวยังคงสถาปัตยกรรม ตัวชี้วัด หรือนิยามงานตามแหล่งที่มาของตน ผลลัพธ์ที่ไม่มีโพรโทคอลร่วมกันจะยังคงแยกจากกัน
| โมเดล | สถาปัตยกรรมหรือหลักฐาน | ขอบเขต |
|---|---|---|
| HQ-SVC | สายงานเริ่มต้นคุณภาพสูง | ความเที่ยงตรง ความชัดเจน และเสถียรภาพในช่วงเสียงสูง |
| YingMusic-SVC | การเปรียบเทียบเนื้อหา/F0/ลักษณะเสียง | การคงลักษณะข้ามผู้ร้องและข้ามภาษา |
| การแยกแหล่งเสียง + SVC | เส้นทางครบถ้วนสำหรับอินพุตแบบมิกซ์ | เสียงรั่วจากการแยกส่งต่อเข้าไปในการแปลง |
ตรวจเนื้อร้องและจังหวะก่อน จากนั้นจึงตรวจการกระโดดของระดับเสียง เสียงซิบิแลนต์ ความพร่าจากลมหายใจ และเสียงแตกในช่วงสูง การทรานสโพสอัตโนมัติเปลี่ยนแรงกดของการใช้เสียง และไม่สามารถสรุปด้วยค่าความคล้ายเฉลี่ยได้
ใช้เสียงอ้างอิงเป้าหมายแบบแห้ง ร้องเดี่ยว ไม่มีดนตรีประกอบ และครอบคลุมช่วงเสียงที่ใช้งานได้ ตัวอย่างสั้นที่มีเสียงก้องอาจทำให้ลักษณะเสียงของห้องดูเหมือนอัตลักษณ์ของผู้ร้อง
การแปลงไม่ได้ล้างลิขสิทธิ์หรือสิทธิของผู้แสดง การเผยแพร่ต่อสาธารณะต้องได้รับอนุญาตทั้งสำหรับการแสดงต้นทางและอัตลักษณ์เป้าหมาย
ระบบไม่รับประกันการปกปิดตัวตน คุณลักษณะของต้นทางอาจยังคงอยู่ ดังนั้น SVC จึงไม่ใช่ตัวกรองความเป็นส่วนตัว
ชื่อโมเดล ตัวเลข และข้อจำกัดอ้างอิงย้อนกลับไปยังบทความ ที่เก็บโค้ด หรือการ์ดโมเดลด้านล่าง