Model
HQ-SVC i YingMusic-SVC: demontaż treści, F0, energii i barwy konwersji głosu śpiewającego
Konwersja głosu / porównanie technologii
Konwersja głosu / porównanie technologii
KONWERSJA GŁOSU ŚPIEWAJĄCEGO
SVC nie domiesza referencji docelowej do źródła. System musi zachować tekst, rytmikę i melodię źródła, a zarazem zastąpić statystyki barwy. Wyciek treści objawia się błędami wymowy lub przenikaniem tła.
Wysokość dźwięku można wyrazić w półtonach jako p=69+12log₂(f₀/440). Automatyczne przesuwanie zakresu pomaga przy dużych różnicach rejestru, ale błędy F0 zmieniają glissanda, oddech i harmonię w nieprawidłowe wskazówki melodyczne.
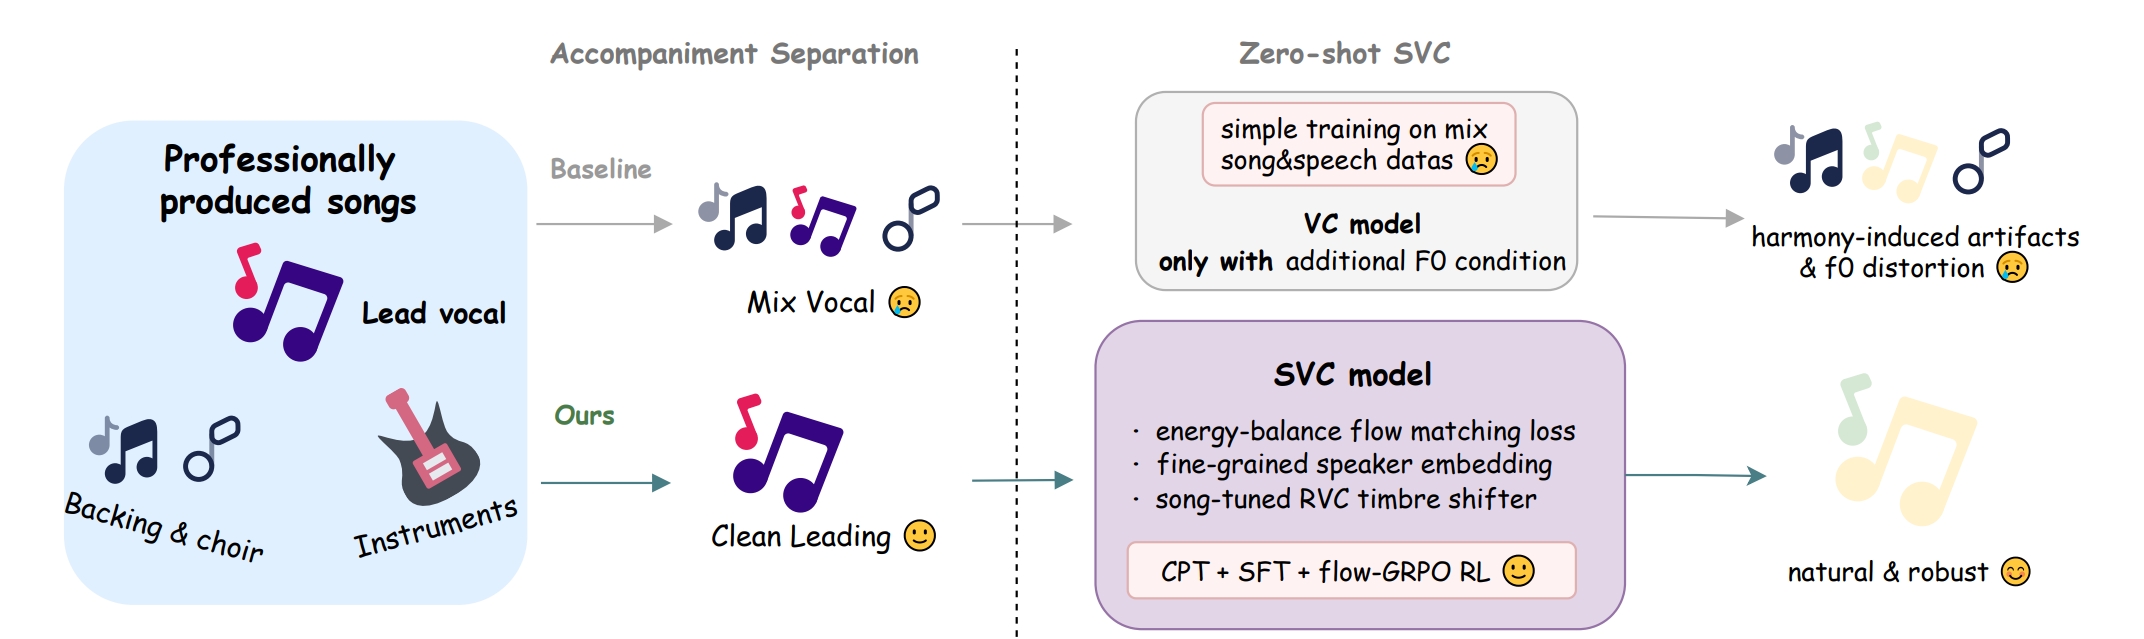
Karta modelu HQ-SVC zawiera kod inferencji, FACodec, RMVPE i zasoby wokodera. YingMusic-SVC publikuje adapter uwzględniający F0, dopasowanie przepływu ze zrównoważoną energią oraz trening pod kątem zanieczyszczeń harmonicznych z rzeczywistych nagrań. Bez wspólnego zbioru testowego materiały publiczne nie pozwalają wskazać jednego zwycięzcy między projektami.
Przenikanie akompaniamentu w źródle zostaje ponownie zabarwione przez konwersję, a pogłos lub dźwięk tła w próbce docelowej mogą zostać uznane za cechę tożsamości. Zarówno źródłowy wokal prowadzący, jak i referencja docelowa powinny być czyste, a skonwertowany materiał należy wyraźnie oznaczyć jako syntetyczny.
Konwersja głosu śpiewającego zachowuje tekst i melodię wykonania, jednocześnie zastępując reprezentację związaną z barwą. HQ-SVC kładzie nacisk na wysokiej jakości łańcuch konwersji; YingMusic-SVC przedstawia inną konstrukcję warunkowania treścią, F0 i mówcą. W odróżnieniu od syntezy wejściem jest istniejące wykonanie wokalne.
SVC ewoluowało od mapowania widmowego w kierunku enkoderów treści, jawnego F0, dekoderów generatywnych i silniejszych reprezentacji mówcy. Rozdzielenie nadal jest niepełne: akcent, dynamika i formanty źródła mogą przenikać, a akustyka pomieszczenia z referencji docelowej może zostać skopiowana.

ŷ=G(c(x_src),F0(x_src),E(x_src),e(x_ref))c(x_src)treść językowaF0,Emelodia i energiae(x_ref)warunek barwy docelowejTreść, F0 i energia pochodzą z wykonania źródłowego, a barwa docelowa z referencji. Niedoskonałe rozdzielenie pozostawia tożsamość źródła lub przenosi zabarwienie pomieszczenia.
Pełny miks wymaga najpierw czystego stemu wokalu prowadzącego. Przenikanie z separacji zostaje ponownie zabarwione przez konwersję i może być trudniejsze do usunięcia, dlatego oba etapy należy oceniać łącznie.
Artykuł, kod i wagi można znaleźć przez HQ-SVC / YingMusic-SVC / artykuł YingMusic-SVC.

Każdy wiersz zachowuje architekturę, metrykę lub definicję zadania ze swojego źródła; wyniki bez wspólnego protokołu pozostają rozdzielone.
| Model | Architektura lub dowód | Zakres |
|---|---|---|
| HQ-SVC | domyślny łańcuch wysokiej jakości | wierność, klarowność i stabilność wysokiego rejestru |
| YingMusic-SVC | porównanie treści/F0/barwy | zachowanie między wokalistami i językami |
| separacja źródeł + SVC | pełna ścieżka dla wejścia mieszanego | przecieki separacji przechodzą do konwersji |
Najpierw należy sprawdzić tekst i rytm, a następnie skoki wysokości, sybilanty, oddechowość i załamania wysokiego rejestru. Automatyczna transpozycja zmienia obciążenie głosu i nie daje się podsumować średnim podobieństwem.
Referencja docelowa powinna być sucha, solowa, bez akompaniamentu i obejmować użyteczny zakres. Krótka próbka z pogłosem może sprawić, że zabarwienie pomieszczenia zostanie uznane za tożsamość.
Konwersja nie unieważnia praw autorskich ani praw wykonawców. Publiczna publikacja wymaga zgody zarówno na wykonanie źródłowe, jak i tożsamość docelową.
System nie gwarantuje anonimizacji; cechy źródła mogą pozostać, więc SVC nie jest filtrem prywatności.
Nazwy modeli, liczby i ograniczenia pochodzą z wymienionych poniżej artykułów, repozytoriów lub kart modeli.