モデル
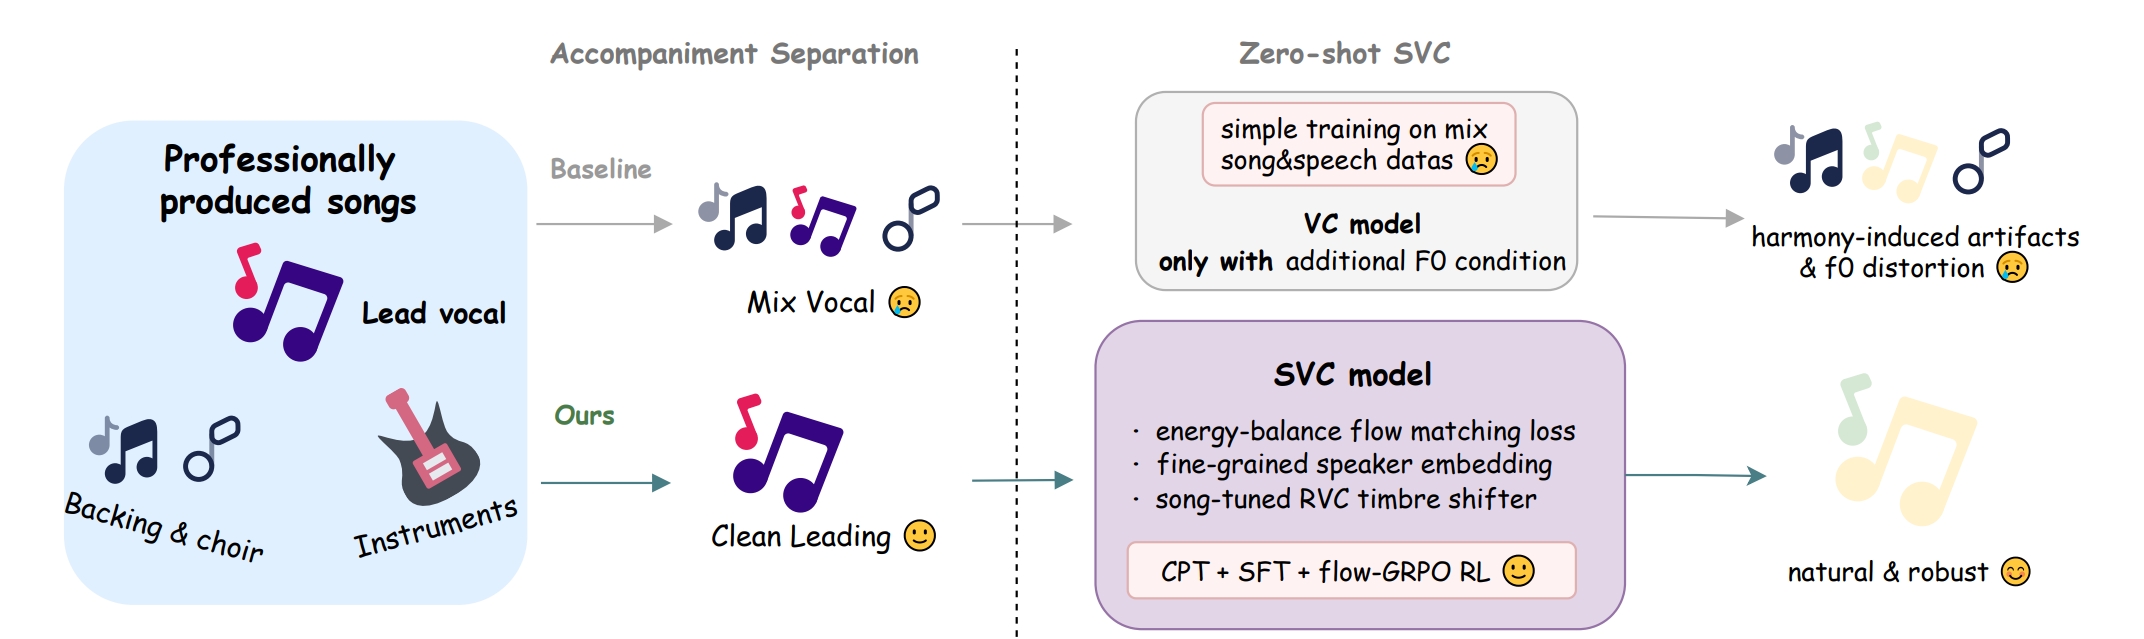
HQ-SVC と YingMusic-SVC: 歌声変換のコンテンツ、F0、エネルギー、音色の解体
歌声変換・技術比較
歌声変換・技術比較
歌声変換
SVCは、ターゲット参照音声をソースに混ぜる処理ではない。ソースの歌詞、タイミング、旋律を保ちながら、音色の統計を置き換える必要がある。内容の漏れは、発音の誤りや背景音の混入として現れる。
音高は半音単位で p=69+12log₂(f₀/440) と表せる。音域差が大きい場合には自動レンジシフトが有効だが、F0の誤りはスライド、息遣い、ハーモニーを誤った旋律の手掛かりに変えてしまう。
HQ-SVCのモデルカードには、推論コード、FACodec、RMVPE、ボコーダー資産が同梱されている。YingMusic-SVCは、F0対応アダプター、エネルギー均衡型フローマッチング、実環境の倍音混入を想定した学習手法を公開している。共通のテストセットがないため、公開資料からプロジェクト横断の単独勝者を決めることはできない。
ソースに漏れた伴奏は変換によって再着色され、ターゲットプロンプトの残響や背景音は話者性と誤認される可能性がある。リードボーカルのソースとターゲット参照音声はどちらもクリーンであるべきで、変換音声には合成物であることを明示する必要がある。
歌声変換は、演唱の歌詞と旋律を維持したまま、音色に関わる表現を置き換える。HQ-SVCは高品質な変換チェーンを重視し、YingMusic-SVCは内容、F0、話者条件の別の設計を提示する。合成とは異なり、入力は既存の歌唱演奏である。
SVCはスペクトル写像から、内容エンコーダー、明示的なF0、生成デコーダー、より強力な話者表現へと発展した。分離はなお不完全で、ソースの訛り、ダイナミクス、フォルマントが漏れる一方、ターゲット参照音声の室内音響がコピーされる場合もある。

ŷ=G(c(x_src),F0(x_src),E(x_src),e(x_ref))c(x_src)言語内容F0,E旋律とエネルギーe(x_ref)ターゲット音色条件内容、F0、エネルギーはソース演奏から、ターゲット音色は参照音声から得られる。分離が不完全だとソースの話者性が残ったり、部屋の色付けが転写されたりする。
フルミックスでは、まずクリーンなリードボーカルstemが必要になる。分離漏れは変換で再着色され、除去がさらに難しくなる場合があるため、両方の段階を併せて監査しなければならない。
論文、コード、重みはHQ-SVC/YingMusic-SVC/YingMusic-SVC論文から確認できる。

各行は出典のアーキテクチャ、指標、タスク定義を維持し、共通プロトコルのない結果は分けて扱う。
| モデル | アーキテクチャまたは根拠 | 対象範囲 |
|---|---|---|
| HQ-SVC | 高品質な標準チェーン | 忠実度、明瞭度、高音域の安定性 |
| YingMusic-SVC | 内容/F0/音色の比較 | 歌手・言語をまたぐ保持 |
| 音源分離 + SVC | 混合入力に対する完全な処理経路 | 分離漏れが変換へ伝播する |
まず歌詞とリズムを確認し、次に音高の跳躍、歯擦音、息成分、高音域の破綻を調べる。自動移調は発声負荷を変えるため、平均類似度だけでは要約できない。
ターゲット参照音声には、ドライで独唱、伴奏がなく、実用的な音域を含む素材を使う。残響の強い短いサンプルでは、部屋の色付けが話者性のように見える場合がある。
変換によって著作権や実演家の権利が消えるわけではない。公開には、ソース演奏とターゲットの話者性の双方について許諾が必要になる。
システムは匿名化を保証しない。ソースの特徴が残る可能性があるため、SVCはプライバシーフィルターではない。
モデル名、数値、制限は、以下の論文、リポジトリ、モデルカードに基づく。