Krea 2: Krea AI veröffentlicht Raw- und Turbo-Gewichte für Bildgenerierung
Krea AI veröffentlicht Krea 2 Raw und Krea 2 Turbo als Open Weights. Der technische Bericht beschreibt Krea 2 als ein von Grund auf trainiertes 12B-Text-zu-Bild-Diffusionsmodell und erläutert Datenfilterung, Caption-Pipeline, Post-Training, Reinforcement Learning sowie Sicherheits- und Lizenzgrenzen.
Modell-News / Krea AI
Krea AI stellte Krea 2 im Juni 2026 vor und veröffentlichte später Raw und Turbo als zwei Checkpoints mit offenen Gewichten. Der offizielle technische Bericht beschreibt Krea 2 als von Grund auf trainiertes Text-zu-Bild-Diffusionsmodell mit 12B Parametern. Zu den Komponenten gehören ein multimodales Sprachmodell, ein Diffusion Transformer und ein Bild-Autoencoder. Krea veröffentlichte außerdem eine Release-Seite, den technischen Bericht, ein GitHub-Repository, eine Hugging Face-Modellkarte und den Lizenztext.
Diese Veröffentlichung stellt Kreas langjährigen Fokus auf „Ästhetik“ in einen Open-Weight-Kontext. Die offiziellen Materialien präsentieren Krea 2 nicht ausschließlich als Modell für Fotorealismus oder Bestenlisten. Im Mittelpunkt stehen Stilfindung, Produktkonzepte, Menschen und Szenen, Materialtexturen sowie kreative Arbeitsabläufe. Raw ist für Training und Forschung vorgesehen, Turbo für schnelle Inferenz; Repository und Modellkarten halten diese Einsatzwege getrennt.
Von der Release-Seite zur Modellkarte
Die öffentlichen Materialien zu Krea 2 verteilen sich auf mehrere Ebenen. Die Produkt-Release-Seite zeigt Beispiele und Anwendungsfälle für Kreativwerkzeuge. Die Open-Source-Release-Seite erklärt, dass die Gewichte von Raw und Turbo verfügbar sind. Das GitHub-Repository stellt Inferenzcode bereit. Die Hugging Face-Modellkarte dokumentiert Modelltyp, Architektur, Lizenz, Trainingsdaten, Sicherheitsmaßnahmen und Verantwortung für Ausgaben. Der technische Bericht wurde am 23. Juni 2026 veröffentlicht; die Seite weist ihn als Lektüre von 58 Minuten aus.
Krea bezeichnet Krea 2 als Text-zu-Bild-Basismodell mit offenen Gewichten für kreative Erkundung. Die Modellkarte nennt als Veröffentlichungsformat offene Gewichte plus Integration in von Krea gehostete Produkte. Laut Modellkarte umfassen die Trainingsdaten öffentlich verfügbare Daten, lizenzierte Daten Dritter und mit proprietären Methoden erzeugte synthetische Daten. Sie gibt außerdem an, dass schädliche Inhalte vor dem Training gefiltert und minderwertige, doppelte oder irrelevante Daten reduziert werden.
Der technische Bericht beschreibt die Datenpipeline genauer. Krea zufolge enthalten die Vortrainingsdaten keine KI-generierten Bilder; interne Klassifikatoren filtern Rauschen, Überbearbeitung, Logos, Wasserzeichen, NSFW-Inhalte, Memes und Screenshots. Die Beschriftungspipeline kombiniert OCR, Metadaten und multimodales Verständnis, um vollständigere Bildbeschreibungen zu erzeugen. Dem Training werden außerdem kürzere Prompts im Stil realer Nutzereingaben beigemischt, damit das Modell sowohl lange Bildunterschriften als auch echte kreative Prompts sieht.
Das Training wechselt von niedriger zu hoher Auflösung
Krea 2 verwendet einen Diffusion Transformer als Rückgrat der Bildgenerierung. Laut technischem Bericht steigt die Auflösung im Vortraining von 256px über 512px auf 1024px. Das endgültige Modell verwendet Rectified-Flow-Loss und v-Parametrisierung. Der Bericht erklärt außerdem, dass das Team iREPA zu Beginn des niedrig aufgelösten Trainings zur schnelleren Konvergenz einsetzte und anschließend entfernte, damit MMDiT eigene Repräsentationen lernen konnte.
Danach durchläuft das Training Midtraining, überwachtes Feintuning, Präferenzoptimierung und Reinforcement Learning. Das Midtraining passt das Modell vor dem überwachten Feintuning an eine Verteilung an, die den nachgelagerten Aufgaben näherkommt. Für das überwachte Feintuning wird eine kleinere, gezielt gefilterte Auswahl besonders ästhetischer Bilder verwendet, um die Gesamtqualität des Checkpoints zu verbessern und Probleme früher Checkpoints mit hoher Sättigung und Texturen zu beheben.
Die Präferenzoptimierung besteht aus zwei Schritten: zuerst ein großer Durchlauf mit synthetischen Präferenzpaaren, danach die Kalibrierung mit internen menschlichen Bewertungen. Die Reinforcement-Learning-Phase verwendet ein GRPO-ähnliches Multi-Reward-Verfahren mit Belohnungsmodellen für Gesamtästhetik, Prompt-Treue, Textdarstellung, Struktur und Artefakte. Der Bericht nennt auch ein eigens trainiertes Artefakt-Belohnungsmodell, das strukturelle Fehler wie zusätzliche Finger, verzerrte Gliedmaßen und verformten Text reduzieren soll.
Der Prompt-Expander gehört zur Veröffentlichung
Der technische Bericht widmet dem Prompt-Expander viel Raum. Krea geht davon aus, dass dichte Prompts oft bessere Bilder erzeugen, während Nutzereingaben häufig kurz, umgangssprachlich und unvollständig sind. Bildmodelle profitieren stärker von detaillierten Beschreibungen, die näher an der Verteilung der Trainingsbeschriftungen liegen. Krea gestaltet den Prompt-Expander deshalb als Abbildung von einem kurzen Prompt auf eine längere, für das Bildmodell geeignetere Beschreibung.
Der Expander wird zunächst durch überwachtes Feintuning aus einem offenen Sprachmodell abgeleitet. Seine Trainingsdaten bestehen aus synthetischen Paaren, die lange Beschreibungen kurzen Nutzerprompts zuordnen; anschließend lernt er die umgekehrte Richtung und erweitert kurze Prompts zu modellfreundlichen Beschreibungen. Danach optimiert Krea mit Reinforcement Learning den Einfluss des Expanders auf die endgültige Bildqualität und ergänzt Prüfungen auf Prompt-Treue, Sicherheit und Einschränkungen. Der Bericht erwähnt außerdem einen Diversitätswert aus DINOv3-Embeddings, der verhindern soll, dass die Ausgaben auf einen einzigen Stil kollabieren.
Raw ist für das Training, Turbo für die Inferenz
Raw und Turbo sind die beiden Namen, die am leichtesten verwechselt werden. Das README des Open-Source-Repositorys trennt sie klar: Raw ist das undestillierte Basismodell und eignet sich besser für LoRA-Training, Nachtraining und Forschung; Turbo ist die destillierte Version für schnelle Inferenz und die alltägliche Text-zu-Bild-Generierung. Die offiziellen Beispiele folgen derselben Logik: LoRAs werden auf Raw trainiert, direkte Generierungen laufen mit Turbo.
Der Unterschied betrifft mehr als nur die Geschwindigkeit. Raw bewahrt mehr Trainingsspielraum für Forschende, die das Modell weiter formen möchten. Turbo wurde nachtrainiert, feinabgestimmt und destilliert und eignet sich dadurch besser für schnelle Prüfungen einer visuellen Richtung. Beide sind Veröffentlichungen mit offenen Gewichten, doch Raw sollte nicht als normaler Einstieg für die Bildgenerierung behandelt und Turbo nicht als Trainingsbasis beschrieben werden.
Die Hugging Face-Modellkarte von Turbo bündelt außerdem Modellfamilie, Veröffentlichungsformat, Quellen der Trainingsdaten, Sicherheitsgrenzen und Lizenzanforderungen. Sie erinnert Betreiber daran, dass Filterung oder Prüfung erforderlich ist und Nutzende für die Ausgaben verantwortlich bleiben. Offene Gewichte senken die Hürde für Forschung und Bereitstellung; sie heben Grenzen durch Urheberrecht, Persönlichkeitsrechte, illegale Inhalte oder Plattformregeln nicht auf.
| Checkpoint | Offizielle Rolle | Am besten geeignet | Abgrenzung |
|---|---|---|---|
| Krea 2 Raw | Undestillierter Basis-Checkpoint | LoRA-Training, Nachtraining, Forschungsexperimente und Stilanpassung. | Er bewahrt Trainingsspielraum; er ist nicht der alltägliche Einstieg für schnelle Generierung. |
| Krea 2 Turbo | In 8 Schritten destillierter Checkpoint | Schnelle Text-zu-Bild-Generierung, Prüfung visueller Richtungen und kreative Iteration. | Er ist der Inferenzweg und sollte nicht als Basis-Checkpoint für weiteres Training beschrieben werden. |
Das Verhalten ähnelt eher einem Generator visueller Richtungen
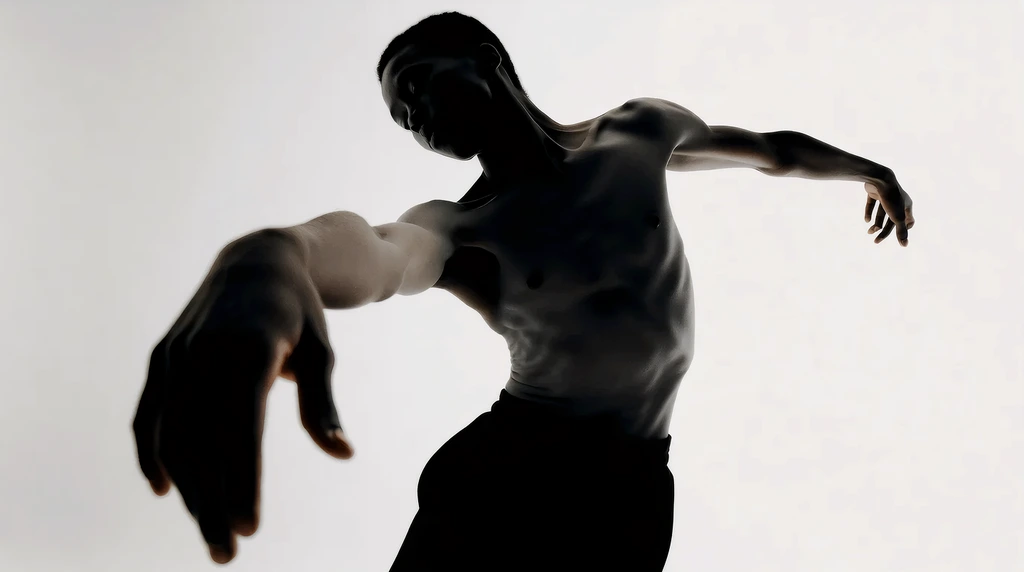
Die Beispiele auf Kreas Release-Seite konzentrieren sich auf Menschen und Szenen, Konzeptprodukte, Modetexturen, Raumstimmungen, filmisches Licht und redaktionelle Illustration. Das Modell wird nicht vor allem als System für Postertext oder Logorekonstruktion präsentiert. Es versucht, Motiv, Material, Licht, Komposition und Stilquelle im selben Bild zu verarbeiten.
Dadurch liegt Krea 2 näher am Anfang eines kreativen Arbeitsablaufs: Ein abstraktes Stilziel wird in mehrere vergleichbare Bilder übersetzt. Marken-Moodboards, Produktkonzepte, Kampagnenbilder, Coverrichtungen, Figurenkonzepte und räumliche Atmosphären tauchen in den öffentlichen Beispielen immer wieder auf. Wenn eine Aufgabe ein strenges Layout, gut lesbaren langen Text, Verpackungstexte oder Markenkennzeichen verlangt, bleiben spezialisierte Fähigkeiten zur Textdarstellung und Layoutsteuerung wichtig.
Bestenlisten sind nur eine Perspektive
Krea verweist auch auf Bewertungen Dritter und Bestenlisten für Modellpräferenzen, doch diese beantworten nur einen Teil der Frage. Präferenzbewertungen für Text-zu-Bild vergleichen üblicherweise Prompts, Ausgabebilder und menschliche Präferenzen innerhalb eines Verfahrens. Sie sind nützlich, um die allgemeine visuelle Wirkung einzuschätzen, ersetzen aber keine aufgabenspezifische Beurteilung. Textdarstellung, chinesische Titel, Logos, komplexes Layout, konsistente Figuren und Regeln für kommerzielle Auslieferung müssen separat geprüft werden.
Krea 2 vereint offene Gewichte und das gehostete Produkt in derselben Modellfamilie. Raw hält den Trainingsraum offen, während Turbo einen direkteren Inferenzweg bietet. Dadurch erhalten Forschende, Entwickelnde und Kreative einen gemeinsamen Satz von Modellmaterialien statt einer Trennung zwischen Forschungs-Checkpoint und Produktmodell.
Der praktische Vergleich lautet daher nicht einfach „welches Modell gewinnt“. Krea 2 Turbo lässt sich besser als schnelles Modell für visuelle Richtungen verstehen; Raw ist der Weg zum Weitertrainieren; größere DiT-Systeme bleiben relevant, wenn ein Arbeitsablauf für ein einzelnes ausgearbeitetes Ergebnis langsamere Inferenz in Kauf nehmen kann. Der Artikel hält diese Aufgaben getrennt, damit die Veröffentlichung nicht auf das allgemeine Etikett „Bildmodell“ reduziert wird.
Die Grenze, die das öffentliche Material setzt
Für diese Veröffentlichung gibt es mehrere gegeneinander prüfbare Quellen: Die Release-Seite zeigt das visuelle Ziel, die Open-Source-Seite erklärt die Verfügbarkeit der Gewichte, der technische Bericht beschreibt das Training, das GitHub-Repository bietet einen Inferenz-Einstiegspunkt und die Hugging Face-Modellkarte nennt Gewichte, Datenquellen, Risiken und Lizenzanforderungen. Jede Quelle erfüllt eine andere Aufgabe; Krea 2 sollte deshalb nicht anhand nur einer davon zusammengefasst werden.
Für Kreative bringt Krea 2 Modelle mit offenen Gewichten zurück in die Diskussion über Ästhetik und Produktgefühl. Für Entwickelnde bietet die parallele Veröffentlichung von Raw und Turbo zwei verschiedene Wege: weitertrainieren oder direkt inferieren. Für Betreiber bleiben die Sicherheits-, Filter- und Lizenzanforderungen der Modellkarte Grenzen, die vor der Einführung berücksichtigt werden müssen.