Krea 2: Krea AI ছবি তৈরির Raw ও Turbo weights প্রকাশ করেছে
Krea AI Krea 2 Raw এবং Krea 2 Turbo-কে open weights হিসেবে প্রকাশ করেছে। প্রযুক্তিগত রিপোর্ট Krea 2-কে শূন্য থেকে প্রশিক্ষিত 12B text-to-image diffusion model হিসেবে বর্ণনা করে এবং data filtering, caption pipeline, post-training, reinforcement learning, safety ও license boundary ব্যাখ্যা করে।
মডেল সংবাদ / Krea AI
Krea AI 2026 সালের জুনে Krea 2 পরিচয় করিয়ে দেয় এবং পরে দুটি উন্মুক্ত-ওজন চেকপয়েন্ট হিসেবে Raw ও Turbo প্রকাশ করে। আনুষ্ঠানিক কারিগরি প্রতিবেদনে এটিকে শুরু থেকে প্রশিক্ষিত 12B text-to-image diffusion model হিসেবে বর্ণনা করা হয়েছে, যার উপাদানের মধ্যে রয়েছে একটি multimodal language model, একটি Diffusion Transformer এবং একটি image autoencoder। Krea একটি প্রকাশনা পাতা, কারিগরি প্রতিবেদন, GitHub repository, Hugging Face model card এবং লাইসেন্সের পাঠ্যও প্রকাশ করেছে।
এই প্রকাশনা Krea-এর দীর্ঘদিনের “নান্দনিকতা” বিষয়ক মনোযোগকে উন্মুক্ত-ওজন পরিসরে নিয়ে এসেছে। আনুষ্ঠানিক উপকরণে Krea 2-কে শুধু photorealism বা leaderboard model হিসেবে দেখানো হয়নি। এটি style exploration, product concept, মানুষ ও দৃশ্য, উপকরণের texture এবং সৃজনশীল workflow ঘিরে উপস্থাপিত। Raw প্রশিক্ষণ ও গবেষণার জন্য, আর Turbo দ্রুত inference-এর জন্য; repository ও model card-এ এই ব্যবহারের পথগুলো আলাদা রাখা হয়েছে।
প্রকাশনা পাতা থেকে model card পর্যন্ত
Krea 2-এর প্রকাশ্য উপকরণ কয়েকটি স্তরে বিভক্ত। পণ্য প্রকাশনার পাতায় নমুনা ও সৃজনশীল টুলের ব্যবহার দেখানো হয়েছে। open-source প্রকাশনার পাতা জানায় যে Raw ও Turbo ওজন পাওয়া যাচ্ছে। GitHub repository inference code দেয়। Hugging Face model card-এ model type, architecture, license, training data, safety measure এবং output-এর দায়িত্ব নথিবদ্ধ করা হয়েছে। কারিগরি প্রতিবেদনটি 23 জুন, 2026-এ প্রকাশিত হয় এবং পাতাটি একে 58 মিনিটের পাঠ হিসেবে চিহ্নিত করে।
Krea, Krea 2-কে সৃজনশীল অনুসন্ধানের জন্য উন্মুক্ত-ওজন text-to-image foundation model বলে। model card-এ প্রকাশনার format হিসেবে উন্মুক্ত ওজনের পাশাপাশি Krea-hosted পণ্যের সঙ্গে integration উল্লেখ করা হয়েছে। এতে বলা হয়, training data-তে publicly available data, third-party licensed data এবং proprietary method-এ তৈরি synthetic data রয়েছে। model card আরও জানায়, প্রশিক্ষণের আগে ক্ষতিকর content ছেঁকে ফেলা হয় এবং নিম্নমানের, duplicate বা অপ্রাসঙ্গিক data কমানো হয়।
কারিগরি প্রতিবেদনে data pipeline সম্পর্কে আরও বিস্তারিত দেওয়া হয়েছে। Krea জানায়, তাদের pretraining data-তে AI-generated image ব্যবহার করা হয় না এবং internal classifier দিয়ে noise, অতিরিক্ত editing, logo, watermark, NSFW content, meme ও screenshot ছেঁকে ফেলা হয়। captioning pipeline OCR, metadata ও multimodal understanding একত্র করে আরও পূর্ণাঙ্গ image description তৈরি করে। প্রশিক্ষণে ছোট user-style prompt-ও মেশানো হয়, যাতে model দীর্ঘ caption-এর পাশাপাশি বাস্তব creative prompt-ও দেখে।
প্রশিক্ষণ নিম্ন থেকে উচ্চ resolution-এ এগোয়
Krea 2 image generation-এর backbone হিসেবে Diffusion Transformer ব্যবহার করে। কারিগরি প্রতিবেদন অনুযায়ী, pretraining 256px থেকে 512px এবং পরে 1024px-এ যায়। চূড়ান্ত model rectified-flow loss ও v-parameterization ব্যবহার করে। প্রতিবেদনে আরও বলা হয়, দলটি শুরুর দিকের low-resolution training-এ convergence দ্রুত করতে iREPA ব্যবহার করেছিল, পরে সেটি সরিয়ে দেয় যাতে MMDiT নিজস্ব representation শিখতে পারে।
এরপর training process midtraining, supervised fine-tuning, preference optimization এবং reinforcement learning ধাপ অতিক্রম করে। supervised fine-tuning-এর আগে midtraining model-কে downstream task-এর কাছাকাছি distribution-এর সঙ্গে মানিয়ে নেয়। supervised fine-tuning ধাপে উচ্চ নান্দনিকতার image-এর ছোট, বিশেষভাবে filtered set ব্যবহার করা হয়, যাতে checkpoint-এর সামগ্রিক মান বাড়ে এবং প্রাথমিক checkpoint-এর অতিরিক্ত saturation ও texture সমস্যা সমাধান হয়।
preference optimization দুটি ধাপে বিভক্ত: প্রথমে synthetic preference pair-এর বড় একটি pass, পরে internal human label দিয়ে calibration। reinforcement learning ধাপে GRPO-সদৃশ multi-reward method ব্যবহার করা হয়, যেখানে সামগ্রিক নান্দনিকতা, prompt অনুসরণ, text rendering, structure ও artifact-এর জন্য reward model থাকে। প্রতিবেদনে আরও বলা হয়, অতিরিক্ত আঙুল, বিকৃত অঙ্গ ও বেঁকে যাওয়া text-এর মতো structural error কমাতে Krea একটি dedicated artifact reward model প্রশিক্ষণ দিয়েছে।
Prompt expander-ও প্রকাশনার অংশ
কারিগরি প্রতিবেদনে prompt expander নিয়ে বিস্তর আলোচনা রয়েছে। Krea-এর মতে, ঘন ও বিস্তারিত prompt প্রায়ই ভালো image তৈরি করে, অথচ user prompt সাধারণত ছোট, কথোপকথনধর্মী ও অপর্যাপ্তভাবে নির্দিষ্ট। training caption distribution-এর কাছাকাছি বিস্তারিত description image model-এর জন্য বেশি উপযোগী। তাই Krea prompt expander-কে ছোট prompt থেকে image model-এর উপযোগী দীর্ঘ caption তৈরির mapper হিসেবে নকশা করেছে।
expander-কে প্রথমে একটি open language model থেকে supervised-fine-tuned করা হয়। এর training data আসে synthetic pair থেকে, যা দীর্ঘ caption-কে ছোট user prompt-এর সঙ্গে map করে; এরপর এটি বিপরীত দিক শেখে—ছোট prompt-কে model-friendly description-এ বিস্তৃত করা। পরে final image quality-তে expander-এর প্রভাব optimize করতে Krea reinforcement learning ব্যবহার করে, সঙ্গে prompt-faithfulness, safety ও constraint check যোগ করে। একটিমাত্র style-এ output collapse হওয়া ঠেকাতে DINOv3 embedding diversity score ব্যবহারের কথাও প্রতিবেদনে বলা হয়েছে।
Raw প্রশিক্ষণের জন্য, Turbo inference-এর জন্য
Raw ও Turbo নাম দুটি সহজেই গুলিয়ে যেতে পারে। open-source repository-এর README স্পষ্টভাবে এগুলো আলাদা করেছে: Raw হলো undistilled base model, যা LoRA training, post-training ও গবেষণার জন্য বেশি উপযোগী; Turbo হলো দৈনন্দিন text-to-image generation-এর জন্য distilled fast-inference version। আনুষ্ঠানিক উদাহরণও একই যুক্তি অনুসরণ করে: Raw-এ LoRA প্রশিক্ষণ দিন এবং Turbo দিয়ে সরাসরি তৈরি করুন।
পার্থক্যটি শুধু গতির নয়। যারা model-কে আরও গড়ে নিতে চান, তাদের জন্য Raw training space-এর বেশি অংশ অক্ষুণ্ণ রাখে। Turbo post-training, fine-tuning ও distillation পেরিয়েছে, তাই দ্রুত visual direction যাচাইয়ের জন্য বেশি উপযোগী। দুটিই উন্মুক্ত-ওজন প্রকাশনা, কিন্তু Raw-কে স্বাভাবিক generation entry point হিসেবে ধরা উচিত নয় এবং Turbo-কে training base বলা উচিত নয়।
Hugging Face-এর Turbo model card-এ model family, release format, training-data source, safety limit ও license requirement-ও একত্র করা হয়েছে। এতে deployer-দের মনে করিয়ে দেওয়া হয় যে filtering বা review আবশ্যক এবং output-এর দায়িত্ব ব্যবহারকারীরই থাকে। উন্মুক্ত ওজন গবেষণা ও deployment-এর বাধা কমায়; copyright, likeness, illegal-content বা platform-rule-এর সীমা তুলে দেয় না।
| Checkpoint | আনুষ্ঠানিক ভূমিকা | সবচেয়ে উপযুক্ত ব্যবহার | সীমা |
|---|---|---|---|
| Krea 2 Raw | Undistilled base checkpoint | LoRA training, post-training, গবেষণামূলক পরীক্ষা এবং style adaptation। | এটি training space ধরে রাখে; দৈনন্দিন fast-generation entry point নয়। |
| Krea 2 Turbo | 8-step distilled checkpoint | দ্রুত text-to-image generation, visual direction যাচাই এবং সৃজনশীল iteration। | এটি inference path; পরবর্তী training-এর base checkpoint হিসেবে বর্ণনা করা উচিত নয়। |
এটি অনেকটা visual direction generator-এর মতো আচরণ করে
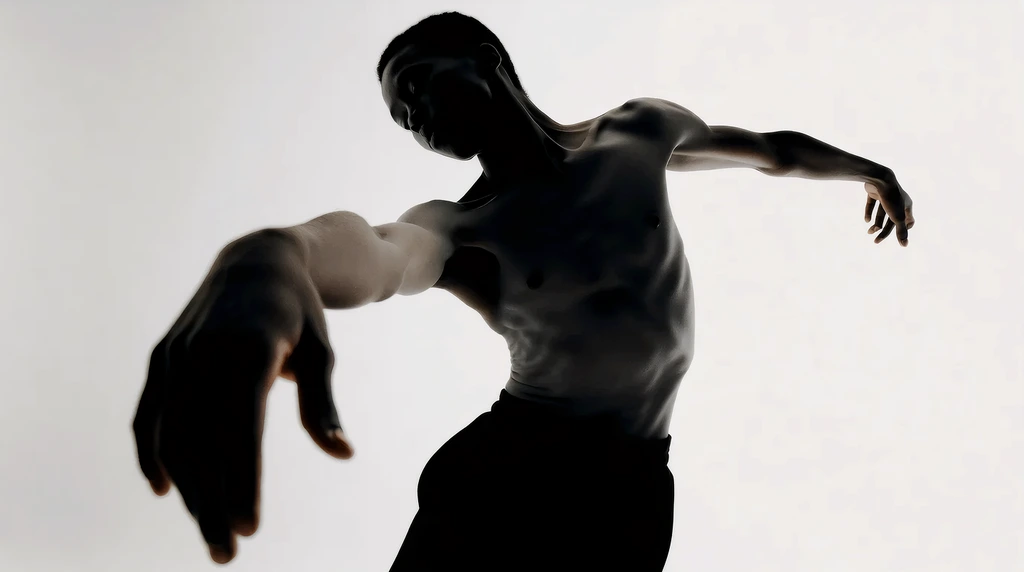
Krea-এর প্রকাশনা পাতার নমুনায় মানুষ ও দৃশ্য, concept product, fashion texture, interior mood, cinematic lighting এবং editorial illustration-এ জোর দেওয়া হয়েছে। model-টিকে প্রধানত poster-text বা logo-reconstruction system হিসেবে দেখানো হয়নি। এটি একই image-এ subject, material, light, composition ও style source সামলানোর চেষ্টা করে।
ফলে Krea 2 সৃজনশীল workflow-এর শুরুর দিকের কাছাকাছি অবস্থান করে: একটি বিমূর্ত style target-কে তুলনাযোগ্য একাধিক image-এ রূপান্তর করা। brand moodboard, product concept, campaign visual, cover direction, character setup এবং spatial atmosphere প্রকাশ্য নমুনায় বারবার দেখা যায়। কাজে strict layout, পাঠযোগ্য দীর্ঘ text, packaging copy বা brand mark দরকার হলে বিশেষায়িত text ও layout-control ক্ষমতা এখনও গুরুত্বপূর্ণ।
Leaderboard কেবল একটি দৃষ্টিকোণ
Krea third-party evaluation ও model preference leaderboard-এর কথাও উল্লেখ করে, কিন্তু সেগুলো প্রশ্নের কেবল একটি অংশের উত্তর দিতে পারে। text-to-image preference evaluation সাধারণত একটি প্রক্রিয়ার মধ্যে prompt, output image ও human preference তুলনা করে। সামগ্রিক visual appeal বোঝার জন্য এগুলো উপযোগী, কিন্তু task-specific judgment-এর বিকল্প নয়। text rendering, চীনা title, logo, জটিল layout, সামঞ্জস্যপূর্ণ character এবং commercial delivery rule—সবকিছুর আলাদা পর্যালোচনা দরকার।
Krea 2 উন্মুক্ত ওজন ও hosted product-কে একই model family-তে রাখে। Raw training space খোলা রাখে, আর Turbo আরও সরাসরি inference path দেয়। এতে researcher, developer ও creator-রা research checkpoint এবং product model-এর মধ্যে বিভাজনের বদলে model material-এর একটি অভিন্ন set পান।
তাই ব্যবহারিক তুলনা শুধু “কোন model জেতে” নয়। Krea 2 Turbo-কে দ্রুত visual-direction model হিসেবে বোঝা সহজ; Raw হলো continuation-training-এর পথ; আর workflow যদি একটি নিখুঁত ফলের জন্য ধীর inference বহন করতে পারে, তবে ভারী DiT system এখনও প্রাসঙ্গিক। নিবন্ধটি এই কাজগুলো আলাদা রাখে, যাতে প্রকাশনাটি একটি সাধারণ “image model” label-এ সমতল হয়ে না যায়।
প্রকাশ্য উপকরণ যে সীমা রেখে যায়
এই প্রকাশনার একাধিক পারস্পরিক যাচাইযোগ্য source রয়েছে: প্রকাশনা পাতায় visual target দেখানো হয়েছে, open-source পাতায় weight availability ব্যাখ্যা করা হয়েছে, কারিগরি প্রতিবেদনে training process বোঝানো হয়েছে, GitHub repository inference entry point দেয় এবং Hugging Face model card-এ weight, data source, risk ও license requirement তালিকাভুক্ত। প্রতিটি source-এর ভূমিকা আলাদা, তাই শুধু একটি থেকে Krea 2-এর সারসংক্ষেপ করা উচিত নয়।
creator-দের জন্য Krea 2 উন্মুক্ত-ওজন model-কে নান্দনিকতা ও product feel-এর আলোচনায় ফিরিয়ে এনেছে। developer-দের জন্য Raw ও Turbo-এর সমান্তরাল প্রকাশনা দুটি আলাদা পথ দেয়: training চালিয়ে যাওয়া অথবা সরাসরি inference চালানো। deployer-দের জন্য model card-এর safety, filtering ও license requirement এমন সীমা হিসেবেই থাকে, যা চালুর আগে সামলাতে হবে।