Krea 2: Krea AI lança pesos Raw e Turbo para geração de imagens
A Krea AI lançou Krea 2 Raw e Krea 2 Turbo como pesos abertos. O relatório técnico descreve o Krea 2 como um modelo de difusão texto-para-imagem de 12B treinado do zero e detalha filtragem de dados, pipeline de captions, pós-treinamento, aprendizado por reforço e limites de segurança e licença.
Notícias de modelos / Krea AI
A Krea AI apresentou o Krea 2 em junho de 2026 e, depois, publicou Raw e Turbo como dois checkpoints de pesos abertos. O relatório técnico oficial o descreve como um modelo de difusão de texto para imagem com 12 bilhões de parâmetros, treinado do zero, formado por um modelo de linguagem multimodal, um Diffusion Transformer e um autoencoder de imagens. A Krea também publicou uma página de lançamento, relatório técnico, repositório no GitHub, cartão no Hugging Face e texto de licença.
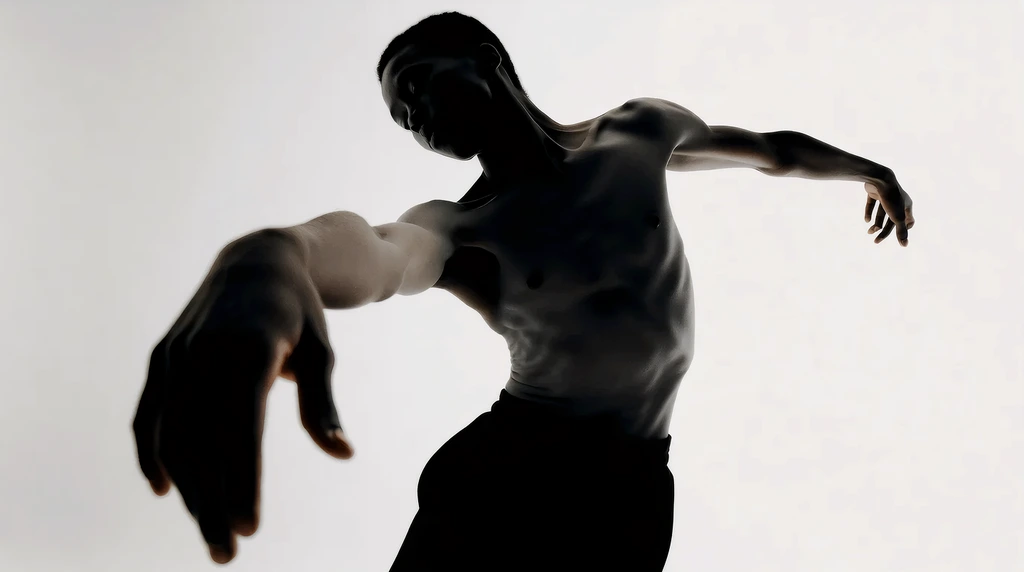
O lançamento coloca a atenção histórica da Krea à “estética” no contexto dos pesos abertos. O material oficial não apresenta o Krea 2 apenas como modelo de fotorrealismo ou de ranking. O foco abrange exploração de estilo, conceitos de produto, pessoas e cenários, textura de materiais e fluxos criativos. Raw se destina a treinamento e pesquisa; Turbo, a inferência rápida. O repositório e os cartões mantêm esses caminhos separados.
Da página de lançamento ao cartão do modelo
O material público do Krea 2 está distribuído em várias camadas. A página do produto mostra amostras e usos em ferramentas criativas. A página de código aberto explica a disponibilidade dos pesos Raw e Turbo. O repositório no GitHub fornece o código de inferência. O cartão no Hugging Face registra tipo, arquitetura, licença, dados de treinamento, medidas de segurança e responsabilidade sobre as saídas. O relatório técnico foi publicado em 23 de junho de 2026 e a página o classifica como uma leitura de 58 minutos.
A Krea chama o Krea 2 de modelo-base de texto para imagem com pesos abertos, voltado à exploração criativa. O cartão define o formato de lançamento como pesos abertos mais integração com produtos hospedados pela Krea. Segundo ele, o treinamento usa dados públicos, dados de terceiros sob licença e dados sintéticos produzidos por métodos proprietários. O documento também informa que conteúdo nocivo é filtrado antes do treinamento e que dados de baixa qualidade, duplicados ou irrelevantes são reduzidos.
O relatório técnico detalha o fluxo dos dados. A Krea afirma que o pré-treinamento não usa imagens geradas por IA e que classificadores internos filtram ruído, edição excessiva, logotipos, marcas d'água, conteúdo NSFW, memes e capturas de tela. O processo de legendagem combina OCR, metadados e compreensão multimodal para produzir descrições mais completas. O treinamento também incorpora prompts curtos no estilo dos usuários, expondo o modelo tanto a legendas longas quanto a instruções criativas reais.
O treinamento avança de baixa para alta resolução
O Krea 2 usa um Diffusion Transformer como núcleo da geração de imagens. Segundo o relatório, o pré-treinamento progride de 256 px para 512 px e então 1024 px. O modelo final emprega perda de fluxo retificado e parametrização v. A equipe também utilizou iREPA no início do treinamento em baixa resolução para acelerar a convergência, retirando-o depois para permitir que o MMDiT aprendesse as próprias representações.
Em seguida, o processo passa por treinamento intermediário, ajuste fino supervisionado, otimização por preferências e aprendizado por reforço. O treinamento intermediário aproxima a distribuição do modelo às tarefas posteriores antes do ajuste supervisionado. Esta etapa usa um conjunto menor e filtrado especificamente por alta qualidade estética, melhorando o checkpoint e corrigindo saturação excessiva e problemas de textura observados nos checkpoints iniciais.
A otimização por preferências se divide em duas fases: primeiro um grande ciclo com pares sintéticos de preferência; depois, calibração com rótulos humanos internos. O aprendizado por reforço usa um método de múltiplas recompensas semelhante ao GRPO, com modelos de recompensa para estética geral, aderência ao prompt, renderização de texto, estrutura e artefatos. O relatório diz ainda que a Krea treinou um modelo de recompensa específico para artefatos, reduzindo erros estruturais como dedos adicionais, membros deformados e texto distorcido.
O expansor de prompts faz parte do lançamento
O relatório dedica bastante espaço ao expansor de prompts. Na visão da Krea, prompts densos costumam produzir imagens melhores, enquanto as instruções dos usuários tendem a ser curtas, conversacionais e pouco especificadas. Modelos de imagem aproveitam melhor descrições detalhadas, mais próximas da distribuição das legendas de treinamento. Por isso, a Krea projetou o expansor como um mapeamento de uma instrução curta para uma legenda mais longa e adequada ao modelo visual.
Primeiro, o expansor recebe ajuste fino supervisionado a partir de um modelo de linguagem aberto. Os dados vêm de pares sintéticos que relacionam legendas longas a prompts curtos e, então, ensinam a direção inversa: expandir instruções breves em descrições úteis para o modelo. A Krea aplica depois aprendizado por reforço para otimizar o efeito do expansor na qualidade final, acrescentando verificações de fidelidade, segurança e restrições. O relatório também cita uma pontuação de diversidade por embeddings DINOv3 para evitar que as saídas convirjam para um único estilo.
Raw serve ao treinamento; Turbo, à inferência
Raw e Turbo são os dois nomes mais fáceis de confundir. O README do repositório os separa com clareza: Raw é o modelo-base não destilado, mais adequado a treinamento de LoRA, pós-treinamento e pesquisa; Turbo é a versão destilada de inferência rápida para gerar imagens no dia a dia. Os exemplos oficiais seguem a mesma lógica: treinar LoRAs no Raw e gerar diretamente com o Turbo.
A diferença não se resume à velocidade. Raw preserva mais espaço de treinamento para pesquisadores que desejam continuar moldando o modelo. Turbo passou por pós-treinamento, ajuste fino e destilação, ficando mais apropriado a verificações rápidas de direção visual. Ambos possuem pesos abertos, mas Raw não deve ser tratado como entrada normal de geração, nem Turbo como modelo-base de treinamento.
O cartão do Turbo no Hugging Face também reúne a família de modelos, formato do lançamento, fontes dos dados, limites de segurança e exigências de licença. Ele lembra que implantações precisam de filtragem ou revisão e que os usuários continuam responsáveis pelas saídas. Pesos abertos reduzem a barreira para pesquisa e implantação; não eliminam limites de direitos autorais, imagem pessoal, conteúdo ilegal ou regras de plataforma.
| Checkpoint | Função oficial | Uso mais indicado | Limite |
|---|---|---|---|
| Krea 2 Raw | Checkpoint base não destilado | Treinamento de LoRA, pós-treinamento, pesquisa e adaptação de estilo. | Preserva espaço de treinamento; não é o caminho cotidiano de geração rápida. |
| Krea 2 Turbo | Checkpoint destilado de 8 etapas | Geração rápida de texto para imagem, testes de direção visual e iteração criativa. | É o caminho de inferência; não deve ser descrito como checkpoint base para treinamento adicional. |
O comportamento se aproxima de um gerador de direção visual
As amostras de lançamento da Krea se concentram em pessoas e cenários, produtos conceituais, texturas de moda, atmosferas de interiores, iluminação cinematográfica e ilustração editorial. O modelo não é apresentado principalmente como sistema de texto em pôsteres ou reconstrução de logotipos. Ele tenta combinar tema, material, luz, composição e referência de estilo na mesma imagem.
Isso aproxima o Krea 2 da etapa inicial de um fluxo criativo: transformar um objetivo abstrato de estilo em várias imagens comparáveis. Painéis de referências de marca, conceitos de produto, peças de campanha, direções de capa, estudos de personagem e atmosferas espaciais aparecem repetidamente nas amostras públicas. Quando a tarefa exige layout rígido, textos longos legíveis, conteúdo de embalagem ou marcas, continuam importantes recursos especializados de texto e controle de layout.
Rankings são apenas uma perspectiva
A Krea também cita avaliações de terceiros e rankings de preferência entre modelos, mas eles respondem apenas a parte da questão. Avaliações de preferência em texto para imagem normalmente comparam prompts, resultados visuais e escolhas humanas dentro de um processo específico. Elas ajudam a ler o apelo visual geral, mas não substituem julgamentos de cada tarefa. Renderização de texto, títulos em chinês, logotipos, layouts complexos, consistência de personagens e regras de entrega comercial exigem análises separadas.
O Krea 2 reúne pesos abertos e o produto hospedado na mesma família. Raw mantém aberto o espaço de treinamento, enquanto Turbo oferece um caminho de inferência mais direto. Assim, pesquisadores, desenvolvedores e criadores recebem um conjunto comum de materiais, em vez de uma separação entre checkpoint de pesquisa e modelo de produto.
A comparação prática, portanto, não se reduz a “qual modelo vence”. Krea 2 Turbo é mais bem entendido como modelo rápido de direção visual; Raw é a rota de continuação do treinamento; sistemas DiT mais pesados seguem relevantes quando o fluxo pode aceitar inferência lenta em troca de um único resultado refinado. Essas tarefas permanecem separadas para que o lançamento não seja resumido pelo rótulo genérico de “modelo de imagem”.
Os limites deixados pelo material público
O lançamento possui várias fontes verificáveis: a página mostra o objetivo visual, a página de código aberto explica a disponibilidade dos pesos, o relatório técnico detalha o treinamento, o repositório no GitHub oferece uma entrada de inferência e o cartão no Hugging Face lista pesos, fontes de dados, riscos e licenças. Cada fonte cumpre uma função distinta, por isso o Krea 2 não deve ser resumido a partir de apenas uma delas.
Para criadores, o Krea 2 recoloca modelos de pesos abertos na discussão sobre estética e acabamento de produto. Para desenvolvedores, o lançamento paralelo de Raw e Turbo oferece duas rotas: continuar o treinamento ou executar inferência diretamente. Para quem implanta, os requisitos de segurança, filtragem e licença da ficha continuam sendo limites a resolver antes do lançamento.