โมเดล
SoulX-Singer และ YingMusic-Singer-Plus: การขับเคลื่อนคะแนนและการอ้างอิงทำนอง เส้นทางการสังเคราะห์เสียงร้องสองเส้นทาง
การสังเคราะห์เสียงร้อง / การเปรียบเทียบเส้นทาง
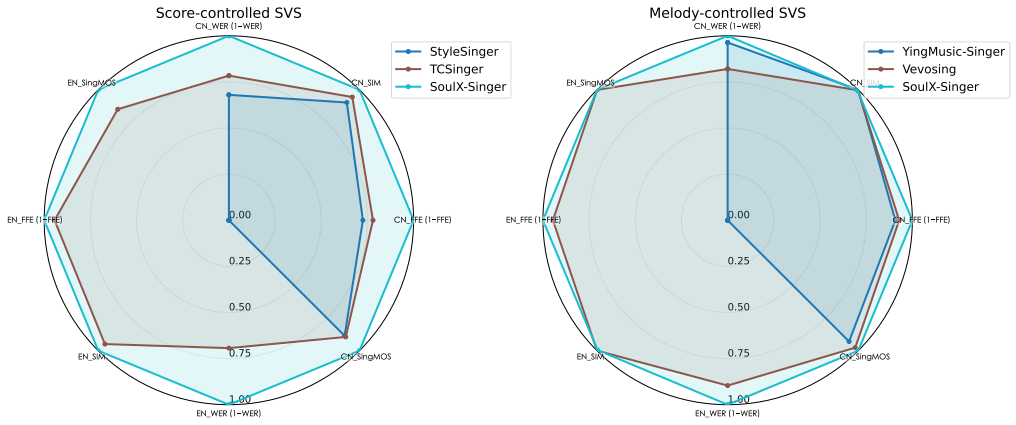
การสังเคราะห์เสียงร้อง / การเปรียบเทียบเส้นทาง
การสังเคราะห์เสียงร้อง
โหมด score ของ SoulX รับเมทาดาทาที่ได้จาก MIDI ส่วน YingMusic-Singer-Plus รับคลิปเสียงร้องที่ให้ทำนองพร้อมเนื้อเพลงเป้าหมาย ระบบแรกต้องอาศัยการจัดแนวระหว่างโน้ตกับเนื้อเพลง ขณะที่อีกระบบเข้ารหัสทำนองจากเสียง
เส้นทางการสร้างเป็นไปตาม dx_t/dt = v_θ(x_t,t | l,m,r) โดยสนามความเร็วมีเงื่อนไขจากเนื้อเพลง ทำนอง และเสียงอ้างอิงสำหรับโทนเสียง การจัดแนวที่คลาดเคลื่อนจะบิดเส้นทางอินทิเกรตนั้นไปสู่ผลลัพธ์ประนีประนอมที่ด้อยระหว่างการออกเสียง จังหวะ และอัตลักษณ์เสียง
SoulX แปลง MIDI เป็นเมทาดาทาแบบแบ่งช่วง พยางค์และจุดเริ่มโน้ตต้องตรงกัน YingMusic ไม่ต้องใช้ MIDI อย่างชัดเจน แต่ต้องมีเสียงร้องทำนองที่สะอาด เพราะเสียงดนตรีประกอบที่รั่วเข้ามาจะปนเปื้อนตัวแทนทำนอง
SoulX-Singer เน้น MIDI เนื้อเพลง และพรอมต์โทนเสียง ส่วน YingMusic-Singer-Plus ยังเน้นการปรับเนื้อเพลงอย่างยืดหยุ่นและการชี้นำทำนองโดยไม่ต้องใส่คำอธิบายประกอบทีละโน้ต การเปรียบเทียบต้องแยกความสูงเสียง ระยะเวลา การเปล่งเสียง และโทนเสียงอ้างอิงออกจากกัน แทนที่จะย่อทั้งสองระบบให้เหลือเพียงสวิตช์เสียงร้องเดียว
สัญญาอินพุตกำหนดว่าระบบเสียงร้องทำอะไรได้บ้าง SoulX-Singer เน้นโทนเสียงแบบ zero-shot และการสร้างเสียงร้อง ส่วน YingMusic-Singer-Plus ผสานเนื้อเพลงเข้ากับเงื่อนไขทำนองหรือโน้ตเพลง ทั้งสองระบบสร้างเสียงร้อง แต่ระบบหนึ่งพึ่งพาเสียงอ้างอิงมากกว่า ขณะที่อีกระบบพึ่งพาโครงสร้างดนตรี
การสังเคราะห์เสียงร้องพัฒนาจากการต่อหน่วยเสียงและแบบจำลองอะคูสติก ผ่าน neural vocoder, codec token และตัวสร้างขนาดใหญ่ ปัญหาที่ยังคงอยู่คือการจัดแนวระหว่างหน่วยเสียง ระยะเวลาโน้ต vibrato ลมหายใจ และโทนเสียง ท่อนฮุกที่ลื่นไหลเพียงท่อนเดียวอาจซ่อนเนื้อเพลงที่ผิดและการคลาดจังหวะข้ามห้องเพลงได้

ŝ=G(lyrics, pitch, duration, e_timbre, c_style)pitchความสูงเสียงหรือเส้นโครงทำนองdurationระยะเวลาของโน้ตe_timbreโทนเสียงจากพรอมต์ที่ได้รับอนุญาตSoulX-Singer ใช้เนื้อเพลง MIDI/เมทาดาทา และพรอมต์โทนเสียง ส่วน YingMusic-Singer-Plus รองรับการชี้นำทำนองที่ยืดหยุ่นกว่า ความสูงเสียงและระยะเวลาเป็นเงื่อนไขจากโน้ตเพลงที่แก้ไขได้ ขณะที่เสียงอ้างอิงทำนองมีข้อมูลการแสดงเพิ่มเติม
ความแม่นยำของความสูงเสียง ระยะเวลา ความชัดเจนของเนื้อเพลง ความคล้ายคลึงของโทนเสียง และการหายใจเป็นรายการตรวจสอบแยกจากกัน ตัวอย่างโน้ตสูงเพียงชิ้นเดียวที่คัดเลือกมาไม่สามารถยืนยันเสถียรภาพตลอดทั้งเพลงได้
สามารถติดตามบทความ โค้ด และน้ำหนักได้จาก SoulX-Singer / บทความ SoulX-Singer / YingMusic-Singer-Plus

แต่ละแถวยังคงสถาปัตยกรรม เมตริก หรือคำนิยามงานจากแหล่งเดิม ผลลัพธ์ที่ไม่มีโปรโตคอลร่วมกันจะถูกแยกออกจากกัน
| แบบจำลอง | สถาปัตยกรรมหรือหลักฐาน | ขอบเขต |
|---|---|---|
| SoulX-Singer | เสียงร้อง zero-shot ที่ขับเคลื่อนด้วยเสียงอ้างอิง | อัตลักษณ์ เนื้อเพลง และเสถียรภาพระยะยาว |
| YingMusic-Singer-Plus | เนื้อเพลงพร้อมทำนอง/โน้ตเพลง | การจัดแนว ช่วงเสียง และ tempo |
| ไปป์ไลน์สังเคราะห์เสียงร้องแบบดั้งเดิม | ลักษณะอะคูสติกที่กำหนดชัดเจนพร้อม vocoder | ควบคุมได้ชัดเจน แต่ความเป็นธรรมชาติข้ามโดเมนมีข้อจำกัด |

เปรียบเทียบทุกคำเพื่อหาคำที่หาย พยัญชนะที่ถูกกลืน การซ้ำ และจังหวะเวลาของพยัญชนะ จากนั้นตรวจสอบการเข้าโน้ต การไล้เสียง และ vibrato ความเป็นธรรมชาติไม่สามารถแทนความถูกต้องของเนื้อหาได้
ตรึงคีย์ BPM อัตราจังหวะ และช่วงเสียงอ้างอิงให้เหมือนเดิม เสียงดนตรีประกอบและ reverb ในเสียงอ้างอิงอาจถูกคัดลอกไปยังผลลัพธ์
การโคลนเสียงนักร้องต้องได้รับอนุญาตอย่างชัดเจน และต้องไม่รองรับการสวมรอย การหลอกลวง หรือการหลีกเลี่ยงสิทธิ
แบบจำลองไม่สามารถแทนการเรียบเรียงเพลงหรือการกำกับเสียงร้องได้ ช่วงเสียง การออกเสียง อารมณ์ และลักษณะเฉพาะของภาษายังคงต้องอาศัยมนุษย์
ชื่อแบบจำลอง ตัวเลข และข้อจำกัดสืบกลับไปยังบทความ รีโพซิทอรี หรือการ์ดโมเดลด้านล่าง