Model
SoulX-Singer i YingMusic-Singer-Plus: zapis nutowy i odniesienie do melodii, dwie ścieżki syntezy głosu śpiewu
Synteza śpiewu / porównanie tras
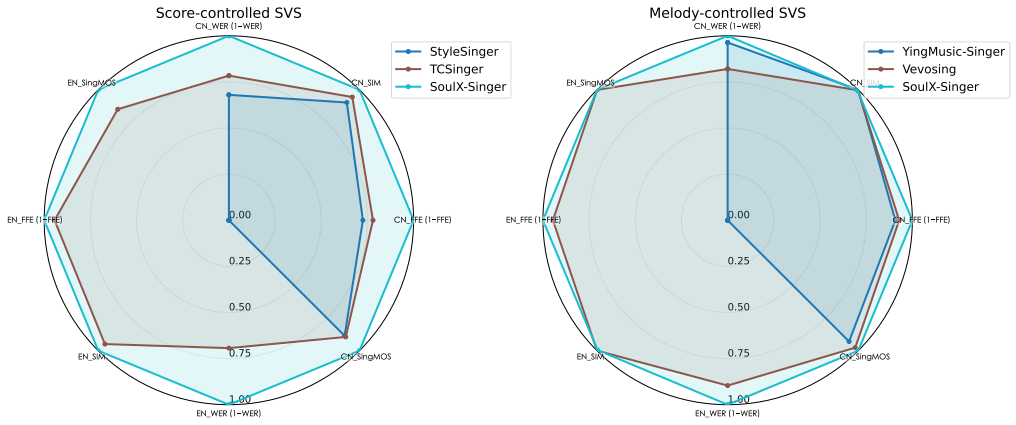
Synteza śpiewu / porównanie tras
© 2026 TelkNet. Wszelkie prawa zastrzeżone.
SYNTEZA ŚPIEWU
Tryb zapisu nutowego SoulX przyjmuje metadane wyprowadzone z MIDI. YingMusic-Singer-Plus przyjmuje próbkę śpiewu, która dostarcza melodię, oraz tekst docelowy. Pierwsze rozwiązanie wymaga zestrojenia nut z tekstem, drugie koduje melodię z dźwięku.
Ścieżka generowania jest opisana równaniem dx_t/dt = v_θ(x_t,t | l,m,r), w którym pole prędkości jest warunkowane tekstem, melodią i referencją barwy głosu. Błędne zestrojenie odchyla tę całkowaną ścieżkę ku niezadowalającemu kompromisowi między wymową, rytmem a tożsamością głosu.
SoulX przekształca MIDI w podzielone na segmenty metadane; sylaby muszą zgadzać się z początkami nut. YingMusic nie wymaga jawnego MIDI, ale potrzebuje czystego wokalu melodycznego, ponieważ przenikanie akompaniamentu zanieczyszcza reprezentację melodii.
SoulX-Singer opiera się na MIDI, tekście i próbce barwy głosu. YingMusic-Singer-Plus kładzie dodatkowy nacisk na elastyczną edycję tekstu oraz prowadzenie melodią bez opisu każdej nuty z osobna. Porównanie musi rozdzielać wysokość, czas trwania, artykulację i referencyjną barwę głosu, zamiast sprowadzać oba systemy do jednego przełącznika śpiewu.
Umowa wejściowa określa możliwości systemu śpiewu. SoulX-Singer skupia się na barwie głosu w trybie zero-shot i generowaniu śpiewu; YingMusic-Singer-Plus łączy tekst z warunkami melodii lub zapisu nutowego. Oba generują śpiew, lecz jeden w większym stopniu zależy od dźwięku referencyjnego, a drugi od ustrukturyzowanego zapisu muzycznego.
Synteza śpiewu przeszła drogę od konkatenacji i modeli akustycznych przez wokodery neuronowe i tokeny kodeka po duże generatory. Stałym problemem pozostaje zestrojenie fonemów, czasu trwania nut, vibrata, oddechów i barwy głosu. Płynny refren może skrywać błędny tekst i przesunięcia narastające między taktami.

ŝ=G(lyrics, pitch, duration, e_timbre, c_style)pitchwysokość dźwięku lub kontur melodiidurationczas trwania nutye_timbrebarwa głosu z próbki użytej za zgodąSoulX-Singer wykorzystuje tekst, MIDI/metadane oraz próbkę barwy głosu; YingMusic-Singer-Plus przyjmuje bardziej elastyczne prowadzenie melodią. Wysokość i czas trwania są edytowalnymi warunkami zapisu nutowego, natomiast referencja melodii zawiera także dodatkowe informacje wykonawcze.
Trafność wysokości, czas trwania, wyrazistość tekstu, podobieństwo barwy i oddechy to osobne kryteria oceny. Jedna wybrana próbka wysokiego dźwięku nie dowodzi stabilności na długości całego utworu.
Publikacje, kod i wagi można znaleźć poprzez SoulX-Singer / publikację SoulX-Singer / YingMusic-Singer-Plus.

Każdy wiersz zachowuje architekturę, miarę lub definicję zadania właściwą dla jego źródła; wyniki bez wspólnego protokołu pozostają rozdzielone.
| Model | Architektura lub materiał dowodowy | Zakres |
|---|---|---|
| SoulX-Singer | referencyjna synteza śpiewu zero-shot | tożsamość głosu, tekst i stabilność długich form |
| YingMusic-Singer-Plus | tekst oraz melodia/zapis nutowy | zestrojenie, skala głosu i tempo |
| tradycyjny potok syntezy śpiewu | jawne cechy akustyczne i wokoder | przejrzyste sterowanie, ale ograniczona naturalność między domenami |

Porównaj każde słowo pod kątem pominięć, połkniętych spółgłosek, powtórzeń i synchronizacji spółgłosek, a następnie sprawdź wejście w wysokość dźwięku, glissanda i vibrato. Naturalność nie zastępuje poprawności treści.
Utrzymuj stałe tonację, BPM, metrum i fragment referencyjny. Akompaniament i pogłos obecne w referencji mogą zostać skopiowane do wyniku.
Klonowanie głosu śpiewaka wymaga wyraźnej zgody i nie może służyć podszywaniu się, oszustwu ani obchodzeniu praw.
Model nie zastępuje aranżacji ani reżyserii wokalnej. Skala głosu, dykcja, emocje i nawyki językowe nadal wymagają pracy człowieka.
Nazwy modeli, liczby i ograniczenia można prześledzić w poniższych publikacjach, repozytoriach lub kartach modeli.