Modello
BandIt e TIGER-DnR: la battaglia per l'assegnazione informatica della separazione a tre tracce per film e televisione
Suono cinematografico e televisivo / DnR
Suono cinematografico e televisivo / DnR
© 2026 TelkNet. Tutti i diritti riservati.
AUDIO CINEMATOGRAFICO / DnR
La separazione cinematografica deve preservare tre grandi classi di sorgenti che convivono per lunghi passaggi. BandIt investe capacità nelle bande spettrali non uniformi; TIGER punta su un modello di sequenza più efficiente.
Si proietta la stima sul riferimento, s_target=<ŝ,s>s/||s||², quindi si calcola SI-SNR=10log10(||s_target||²/||ŝ-s_target||²). Il guadagno viene eliminato, ma la sfocatura dei transienti e i danni spaziali richiedono comunque prove d'ascolto.
BandIt modella le regioni più dense di informazione con bande non uniformi e comunica attraverso di esse. Il confronto a parità di protocollo riporta 10.9 dB, sotto il checkpoint medium rilasciato di SFC-Locoformer a 11.8 dB. BandIt è quindi un termine di confronto architetturale, non la scelta predefinita.
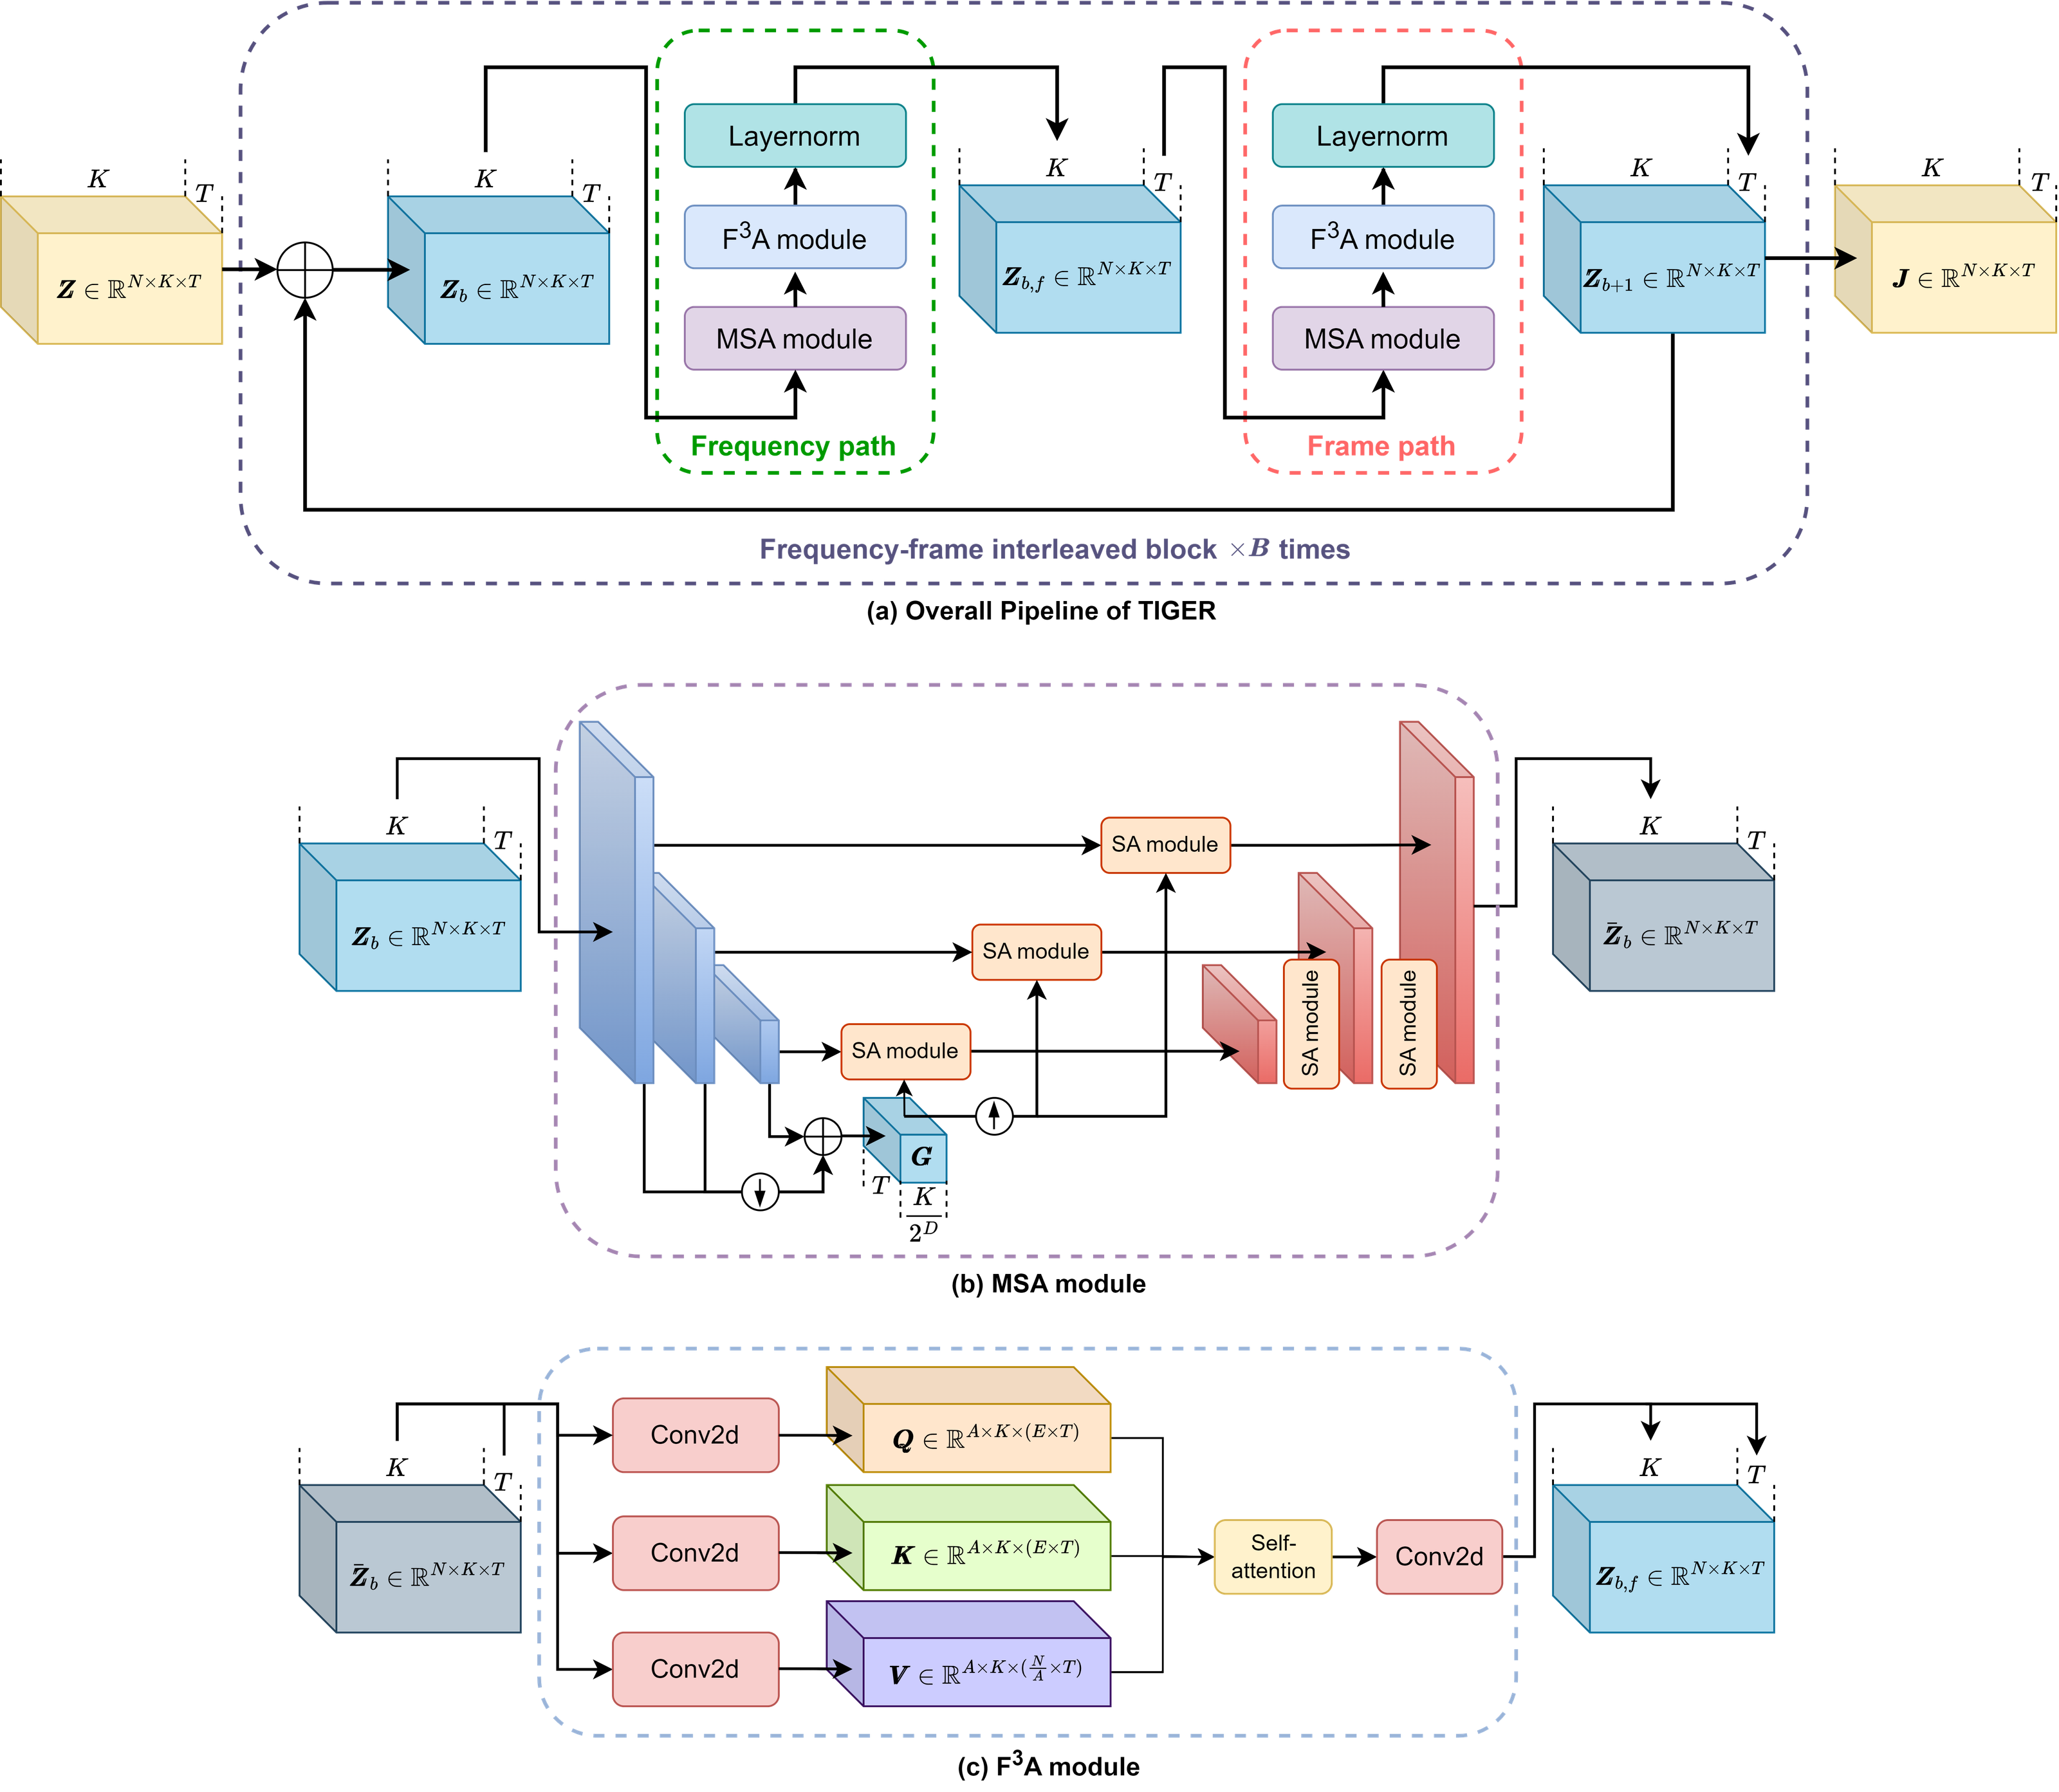
TIGER-DnR è riportato intorno a 9.8 dB nel corrispondente contesto DnR e privilegia un'interazione tempo–frequenza efficiente. Quel numero è utile solo con il suo protocollo dichiarato; velocità, licenza e qualità di separazione restano assi distinti.
DnR ha fissato dialoghi, musica ed effetti come obiettivo condiviso della separazione cinematografica. BandIt modella bande di frequenza non uniformi, mentre TIGER riduce il costo delle sequenze lunghe: rispondono a domande ingegneristiche diverse invece di sostituirsi a vicenda.
SFC-Locoformer riporta in seguito 11.8 dB nella stessa tabella DnR v2 in cui BandIt dichiara 10.9 dB. Le evidenze pubbliche di TIGER insistono sull'efficienza e su esperimenti separati. Senza una riga corrispondente resta un modello selezionabile, non una posizione inventata in classifica.

h_b=Enc_b(X[F_b,:]), Ŝ=Dec({h_b}_{b=1}^B)F_bbin di frequenza nella banda bEnc_bcodifica interna alla bandaDecricostruzione tra bandeBandIt organizza lo spettro complesso in bande non uniformi prima di scambiare informazioni dentro e tra le bande. TIGER punta su una rappresentazione sequenziale più economica. Entrambi emettono stem DnR distribuendo il calcolo in modo diverso.
I numeri si possono accostare solo quando split, frequenza di campionamento, definizioni degli stem e implementazione della metrica coincidono. Lasciare vuota la casella di TIGER in assenza di un protocollo corrispondente è più rigoroso che prendere in prestito un'altra tabella.
Paper, codice e pesi sono ripercorribili nel confronto BandIt / TIGER / DnR.

Ogni riga conserva la propria architettura di origine, la metrica o la definizione del task; i risultati senza un protocollo condiviso restano separati.
| Modello | Architettura o evidenza | Ambito |
|---|---|---|
| SFC-Locoformer medium | 11.8 dB SI-SDR | riferimento di qualità attuale nella stessa tabella DnR v2 |
| BandIt | 10.9 dB SI-SDR | baseline a bande suddivise nello stesso protocollo |
| TIGER-DnR | evidenze di efficienza mostrate a parte | nessuna posizione senza una riga di tabella corrispondente |

Sui dialoghi si controllano sibilanti, respiri e battute lontane; sulla musica, fantasmi di parlato e percussioni danneggiate; sugli effetti, la continuità di passi, porte e ambiente. La SI-SDR media non esegue questi controlli d'ascolto.
I master di consegna contengono ducking, limiting, fold-down dei canali ed elaborazione del loudness. Il protocollo mono di un paper è una baseline riproducibile, non la totalità dei master. I metadati di file e modello rendono possibile un A/B a livello di traccia.
Gli effetti restano un contenitore ampio, non passi, pioggia, traffico o applausi. Tre stem non equivalgono a una comprensione del suono a livello di oggetto.
I punteggi pubblicati dipendono da versione del dataset, frequenza di campionamento e calcolo. Ogni riga delle classifiche conserva direzione della metrica, protocollo e fonte.
Nomi dei modelli, numeri e limiti sono riconducibili ai paper, ai repository o alle model card elencati sotto.